로컬 TTS 뽑기 · 4화
Drama3는 LoRA 없이 18초 레퍼런스로 채널 목소리를 냈다: 걸린 것은 문단 속 긴 침묵이었다
Fish Audio의 새 TTS 모델 Drama3에 18초짜리 레퍼런스와 그 대본만 넣어 부르바키 채널 목소리를 냈다. 영상 두 편 29문단을 받아쓰기로 되돌려 보니 원고와 거의 같았지만, 맥에서 만든 18문단 중 13문단에 1.3~4.2초 침묵이 끼어 잘라 내야 했다.
1~3화에서는 채널 나레이션 목소리를 집 기계에서 내려고 Fish S2 Pro에 LoRA를 학습시켰다. 목소리를 잡은 것은 레퍼런스였고 LoRA는 조금 거드는 정도였다. 10월에 Fish Audio가 새 음성 모델 Drama3를 냈다. 10월 19일과 20일에 이 모델을 학습 없이 레퍼런스만으로 돌려 영상 두 편의 나레이션을 만들었다.
Drama3는 레퍼런스 음성과 그 대본만으로 목소리를 따라 한다
Drama3는 한국어도 읽는 MoE 구조의 TTS 모델이고, 원본 가중치는 FP8로 배포됐다. 이름 붙은 기본 목소리가 없어서 레퍼런스 없이 돌리면 목소리를 그때그때 지어낸다. 채널 나레이션처럼 같은 목소리가 필요하면 레퍼런스 음성 한 토막과 그 음성의 정확한 대본을 같이 넣는다.
레퍼런스는 두 개다. 부르바키 채널은 2화에서 만든 장문 검증 샘플 하나(세 문장, 18.4초), 시황 채널은 채널 인트로 16.3초를 썼다. 라이선스는 Fish Audio Community License로, 1화의 S2 Pro와 달리 연 매출 50만 달러 미만이면 상업적으로 써도 무료다.
시황 영상은 DGX Spark에 띄운 서버로, 부르바키 영상은 맥 스튜디오에서 MLX 8비트 변환본으로 만들었다. 공식 배포는 CUDA용이고 MLX 변환본은 커뮤니티가 만든 비공식판이다. 첫 시험 뒤로는 시드를 고정해 같은 결과를 다시 만들 수 있게 했다.
부르바키 목소리는 첫날 청취 검수를 통과했다
10월 19일 첫 시험에서 결정론을 설명하는 두 문장짜리 문단을 읽혔다. 레퍼런스 없이 돌린 첫 결과는 첫 문장만 읽고 멈췄는데, 23.2초 파일 중 16.6초가 침묵이었다. 같은 문단을 부르바키 레퍼런스로 두 번 읽혔고 두 번째 결과를 들어 보고 좋다고 판단했다. LoRA는 쓰지 않았다.
시황 영상 11문단은 원고와 같게 읽혔고 1017만 판정하지 못했다
다음은 시황 영상의 나레이션이다. 원고 11문단을 하나씩 따로 만들었다. 문단 안에 1.2초 넘는 침묵이 있거나 초당 3.5자보다 느리면 시드를 바꿔 다시 만들게 했고, 11문단 중 3문단을 한 번씩 다시 만들었다.
Whisper large-v3로 받아 적으니 숫자 표기 말고는 원고와 다른 글자가 없었다. 다만 받아쓰기는 “이십오억 칠천오백만”을 숫자로 바꿔 적기 때문에 발음 확인은 따로 했다. 발음 검사기는 숫자를 한글 발음으로만 받아 적는다. 이 검사기로 숫자 8곳을 보니 연도·분기·금액·퍼센트·1차·2차 7곳은 기계 검사를 통과했다. “1017”(일공일칠)은 다시 만든 결과까지 모두 “일곱 일질”이나 “일공 일질”로 들려 판정 불가로 남았다.
급하게 들린 원인은 Drama3가 아니라 옛 영상에 끼워 맞춘 편집이었다
첫 비교본은 원래 영상(141.5초)의 문단 시작 위치에 새 음성을 얹었다. Drama3 11문단은 합쳐서 143.9초라 자리가 모자랐고, 8문단을 최대 1.14배로 빠르게 돌렸다. 각 문단은 다음 문단이 시작하기 0.2초 전에 끝나게 했다.
10월 20일 아침에 들어 보니 문장이 끝나고 숨 쉴 틈 없이 다음 문장이 들어왔다. 원음을 재 보니 Drama3는 문장 끝 24곳에서 이미 0.66~1.29초씩 쉬고 있었다. 문장 끝마다 최소 0.65초를 쉬게 하는 단계를 넣어도 늘어난 곳이 없었다. 급하게 들린 것은 1.14배 가속과 0.2초 간격 때문이었다.
가속을 빼고 문단 사이를 0.8초로 두었다. 자막과 장면 시간을 새 음성에 맞춰 다시 렌더하니 영상이 141.5초에서 155.7초가 됐다. 이 속도를 앞으로의 기본값으로 정했다.
최종 영상의 숫자·용어 28곳은 23곳 통과, 4곳 불일치 후보, 1곳 판정 불가였다. 불일치 후보 4곳은 모두 GPU를 “지피유”로 읽는 대목이고, 판정 불가는 1017이다. 이전 S2 Pro LoRA 목소리로 만든 판에서도 GPU 대목과 1017이 같은 검사에 걸렸다. 그래서 Drama3의 발음 문제인지 검사기의 한계인지는 아직 가리지 못했다. 기계 음향 검사는 보류로 남았고, 영상은 내가 직접 끝까지 들어 보고 문제없다고 판단해 10월 20일 아침에 올렸다.
맥 8비트로 만든 5분 원고는 18문단 중 13문단에 긴 침묵이 끼었다
같은 날 부르바키 채널의 5분짜리 「내 속도로 가기」 원고를 맥에서 만들었다. 본편 18문단과 쇼츠 두 편 8문단이고, 속도는 1배 그대로다.
Whisper large-v3-turbo로 받아 적으니 본편 1,514자 중 한 글자(“아침의”가 “아침에”)만 달랐고 쇼츠는 다른 글자가 없었다. 글자만 비교하는 받아쓰기로는 침묵이 드러나지 않는다. 파형을 재 보니 18문단 중 13문단에 1.31~4.23초짜리 침묵이 23곳 끼어 있었다. 바닥 소리는 -90~-74dBFS로 거의 디지털 무음이었다.
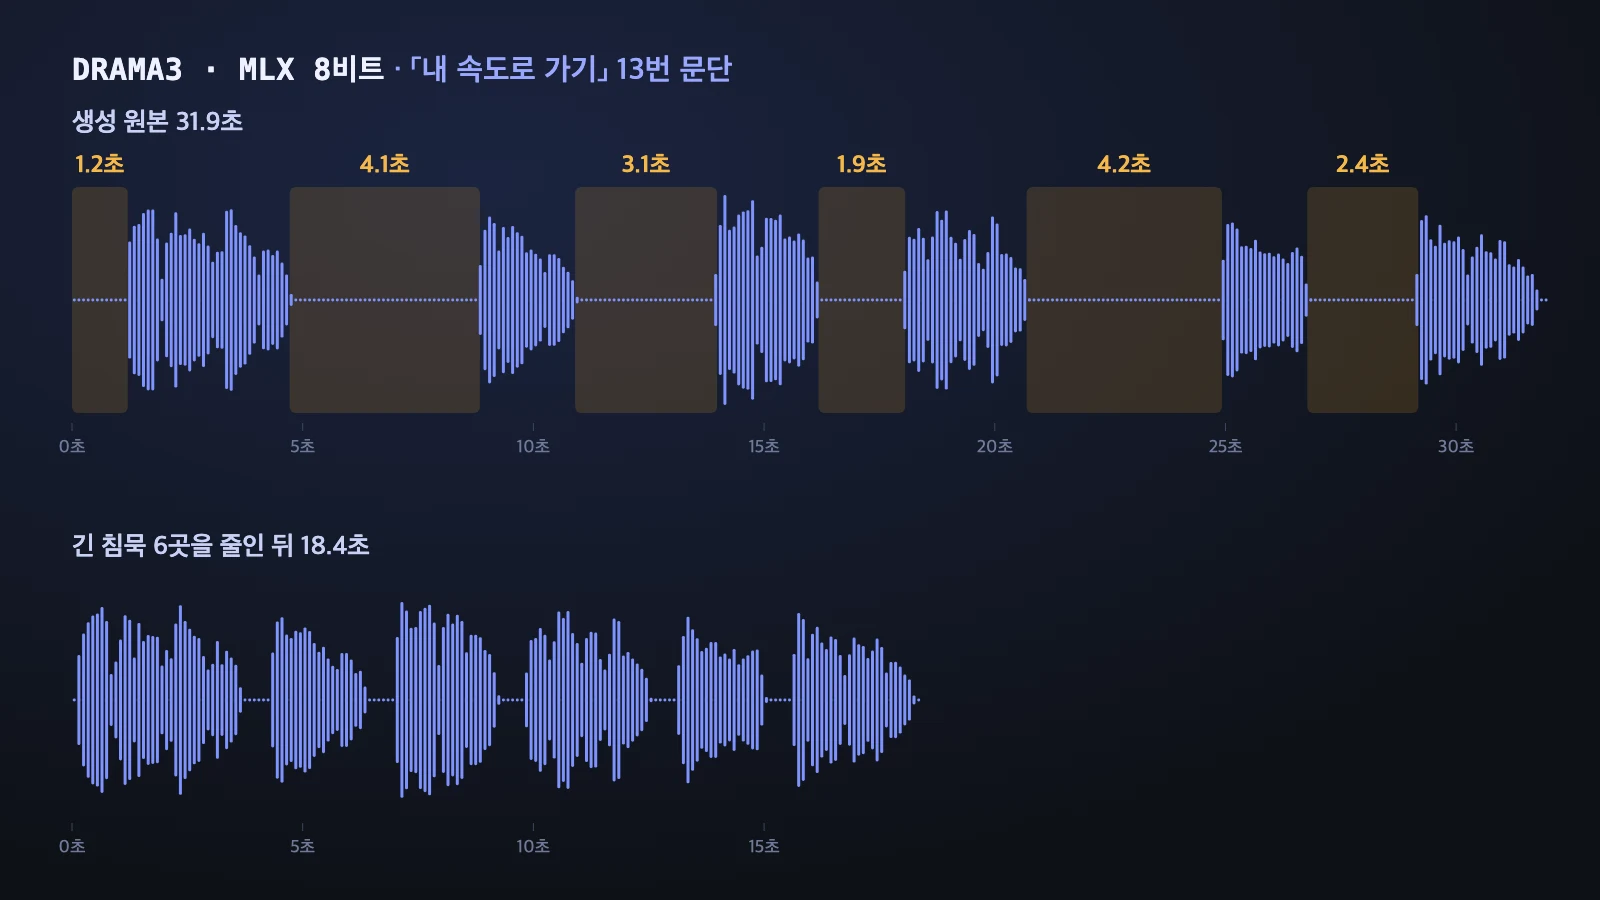
1.25초가 넘는 침묵은 가운데를 잘라 0.65초로 줄였다. 말소리 샘플은 하나도 바꾸지 않았고 본편 음성은 320.9초에서 284.4초가 됐다. 그다음 0.45초보다 짧은 문장 사이 23곳은 3화처럼 방 소리로 0.5초까지 늘렸고, 문단 사이는 0.85초로 맞췄다. 최종 믹스는 인트로를 포함해 304.8초다.
화자 유사도 검사는 침묵을 자르기 전에 구간 4곳을 경고했는데, 네 곳 모두 긴 침묵이 걸친 구간이었다. 자른 뒤에는 경고가 없었다. 2화 장문 샘플 3개와 비교한 문단 전체 유사도는 0.80~0.91이었다. 10월 15일 S2 Pro LoRA로 만든 영상에서 한 문장이 고함처럼 튀고 문단 음량이 7dB 넘게 오르내린 일이 있어서 고음·고음량 검사도 돌렸다. 26문단 모두 0건이었고 본편 문단 음량 차이는 3.3dB 안이었다.
저자 이름은 다시 뽑지 않고 원고에서 뺐다
발음 검사기는 본편 13곳 중 12곳을 통과시켰다. 걸린 곳은 “토머스 길로비치”로, 받아쓰기 모델 두 개가 모두 “토마스”로 들었다. 같은 설정으로 그 문장만 한 번 다시 만들었지만 결과가 같았다. 검사 문턱을 낮추거나 통과할 때까지 다시 만들지 않는다는 규칙에 따라 나레이션은 책 제목으로 시작하게 하고, 저자 이름은 화면 출처 표시와 영상 설명에 넣었다. 음성은 새로 만들지 않았다. 이름 부분 2.63초만 쉼 자리에서 잘라 냈다. 최종 믹스에서는 본편 11곳과 쇼츠 9곳이 모두 통과했다.
판정: 두 영상 나레이션을 Drama3로 만들었고 부르바키 원고의 청취 검수가 남았다
LoRA 학습 없이 레퍼런스 한 토막으로 채널 목소리가 나왔고, 받아쓰기로 본 내용은 두 영상 모두 원고와 거의 같았다. 문제는 문단 속 긴 침묵이었다. DGX Spark에서는 다시 만들기로, 맥에서는 침묵만 잘라 내는 방식으로 처리했다. 맥 쪽 생성 단계에는 초당 글자 수 검사만 있었고, 이 검사도 받아쓰기도 침묵을 잡지 못했다. 시황 영상 때처럼 긴 침묵 검사를 생성 직후에 둬야 한다.
1017과 GPU 읽기가 실제 발음 문제인지는 아직 모른다. 부르바키 5분 원고도 기계 검사만 통과했고, 사람이 처음부터 끝까지 듣는 검수는 아직 하지 않았다. 1화에서 정한 대로 자동 검사는 불량을 거르는 데만 쓰고 채택은 들어 보고 정한다.
다음 화에서는 같은 Drama3를 맥 8비트·4비트, DGX Spark, RTX 5090에서 돌린 속도와 품질을 비교한다.