사유고2
DGX Spark의 로컬 모델이 서재의 책을 원문 10분의 1 크기 구조 지도로 바꾸고, 맥 앱에서 모든 책의 주장·근거·용어·화자를 가로질러 찾는다
목차 · 9
사유고2는 집의 DGX Spark에서 도는 로컬 모델이 서재의 책을 한 권씩 구조 지도로 바꾸고, 맥 앱에서 그 지도를 읽고 찾는 서재다. 지도에는 책의 중심 물음과 논점, 핵심 주장, 그 주장을 받치는 근거와 사례와 조건과 반론, 용어, 그리고 저자가 아닌 사람의 말이 들어간다. 항목마다 원문 문장 하나에 걸려 있다. 2026년 10월 3일 새벽 3시 기준으로 지도를 만들 책 704권 가운데 109권이 끝났고, 스파크 두 대가 남은 책을 계속 만들고 있다.
사유고는 찍어 둔 종이책에 물어보면 근거를 붙여 풀어서 답하는 서재다. 책을 이해시키는 서술형이다. 그런데 책 수백 권이 쌓이자 다른 것이 필요해졌다. 여러 책이 같은 주제를 어떻게 다르게 말하는지 한 번에 늘어놓고, 데이터로도 쓸 수 있는 정렬된 구조다. 그렇다고 키워드만 뽑아서는 뜻이 사라진다. 사람이 읽어도 바로 이해되고, 원문보다 훨씬 작고, 뜻이 그대로 살아 있는 구조로 책을 바꾸고 싶었다. 화면은 모두 2026년 10월 3일 새벽 맥 앱에서 찍었다.
책 한 권을 원문의 10분의 1 크기 지도로 바꾼다
스파크의 로컬 모델 Qwen3.8 Flash Next가 책을 구간별로 읽고, 논점마다 핵심 주장, 받침, 용어를 각각 세 개까지만 뽑는다. 항목 하나에는 명제 하나만 담는다. 문장은 해설자의 말투가 아니라 저자가 직접 정리한 말투로 쓴다. 마지막에 책 전체의 중심 물음과 답, 큰 축 세 개에서 여섯 개를 만든다.
처음에는 한 권을 14단계로 꼼꼼히 쪼개는 방식으로 시작했다. 대표 책 한 권에 230만 토큰을 생성할 판이었고, 네다섯 시간이 걸렸다. 그래서 구간마다 한 번 부르고 걸린 항목만 고치는 경량 지도로 바꿨다. 같은 책이 4.7분, 생성 3.2만 토큰으로 끝났고, 지도 분량은 원문의 9~12%였다.
서재에서 지도가 끝난 책부터 본다
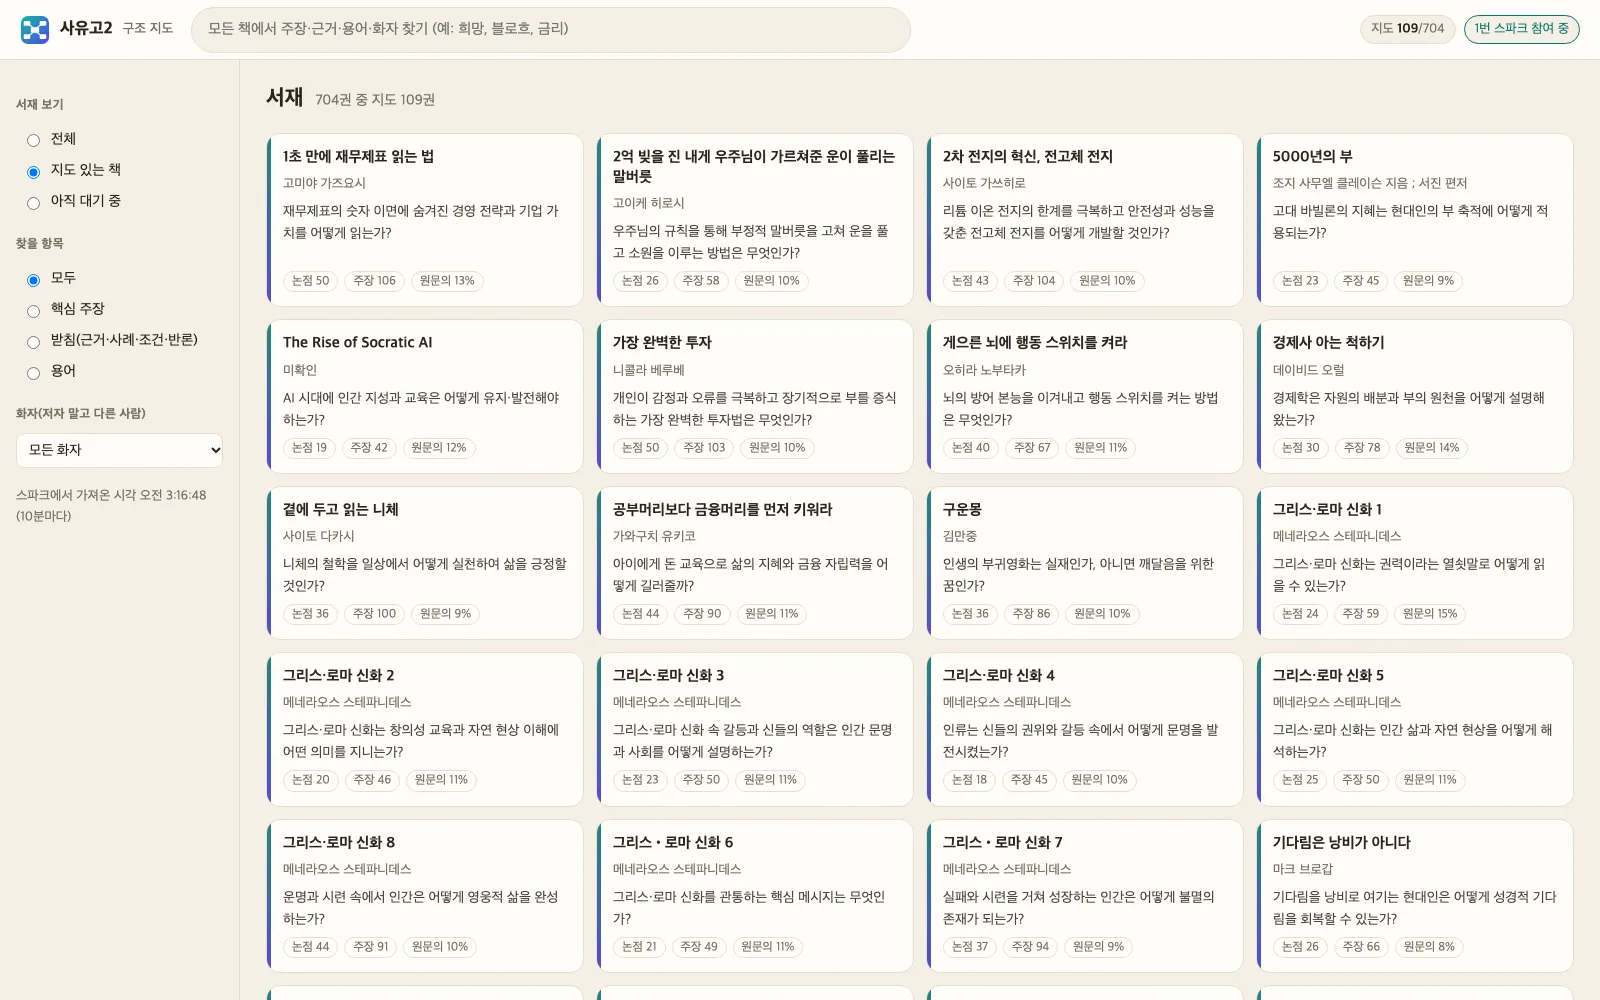
앱을 열면 서재가 나온다. 책마다 중심 물음 한 줄과 논점 수, 주장 수, 원문 대비 분량이 붙는다. 지도가 끝난 책이 먼저 오고, 아직 차례를 기다리는 책은 흐리게 뒤에 선다. 머리말 오른쪽에는 지도가 몇 권 끝났는지와 스파크가 일하는 중인지가 보인다.
한 단어로 모든 책의 주장과 근거를 찾는다
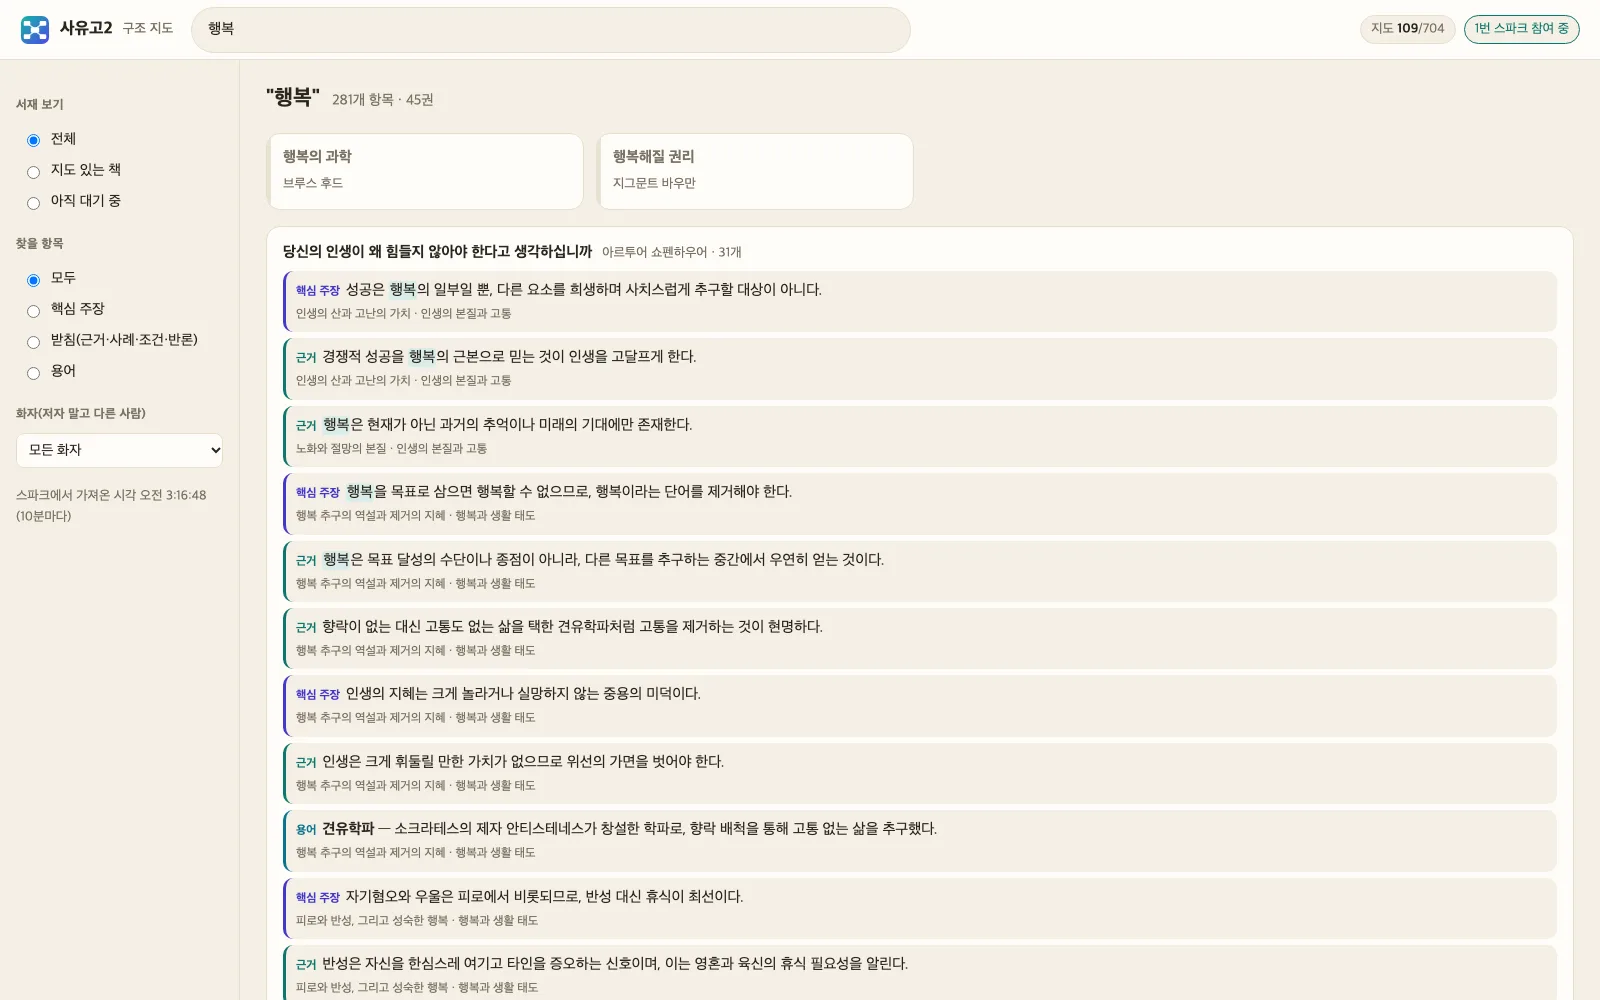
검색창에 한 단어를 넣으면 지도가 있는 모든 책에서 그 말이 들어간 주장, 근거, 사례, 용어를 찾는다. 결과는 책별로 묶이고, 걸린 항목이 많은 책이 먼저 온다. 항목마다 핵심 주장인지 근거인지 용어인지가 붙고, 그 항목이 어느 논점과 어느 큰 축에 속하는지가 아래에 적힌다. 핵심 주장만, 받침만, 용어만 골라 볼 수도 있다.
저자가 아닌 사람의 말은 화자별로 모은다
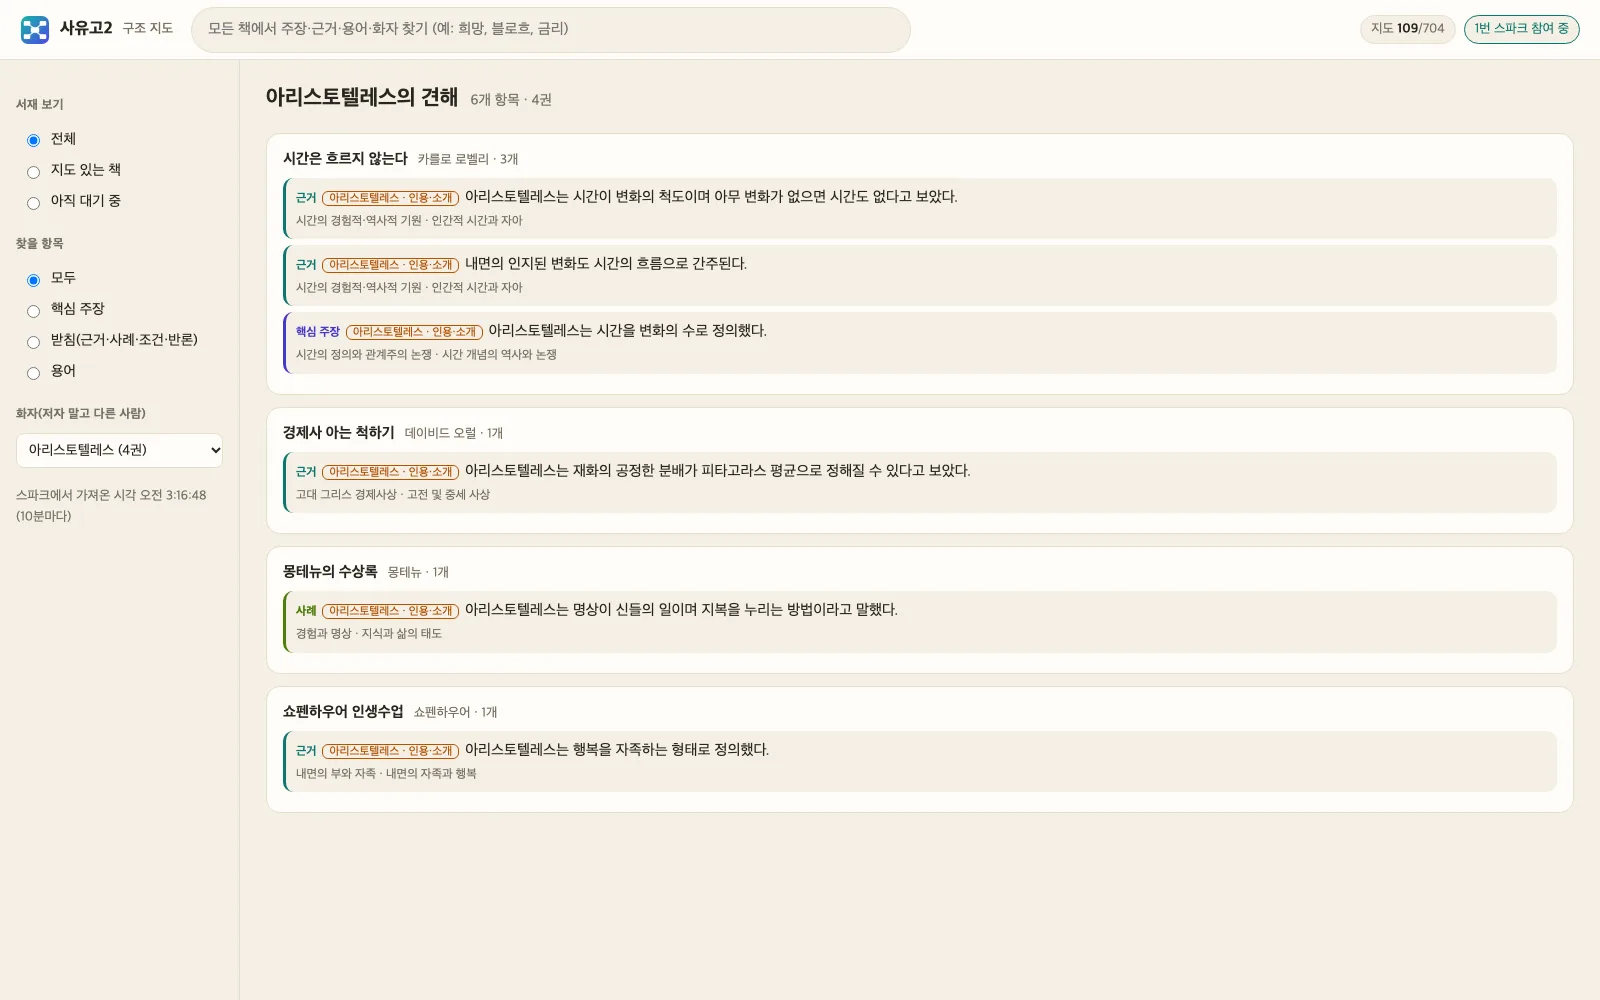
책에는 저자의 말만 있지 않다. 다른 사상가를 인용하고, 소개하고, 반박한다. 지도는 그런 항목에 화자와 저자의 태도를 따로 단다. 인용·소개인지, 반박 대상인지다. 그래서 화자를 고르면 한 인물의 견해가 여러 책에서 어떻게 다뤄졌는지 한 화면에 모인다.
책 화면은 숫자, 마인드맵, 큰 그림, 논증 지도 순서다
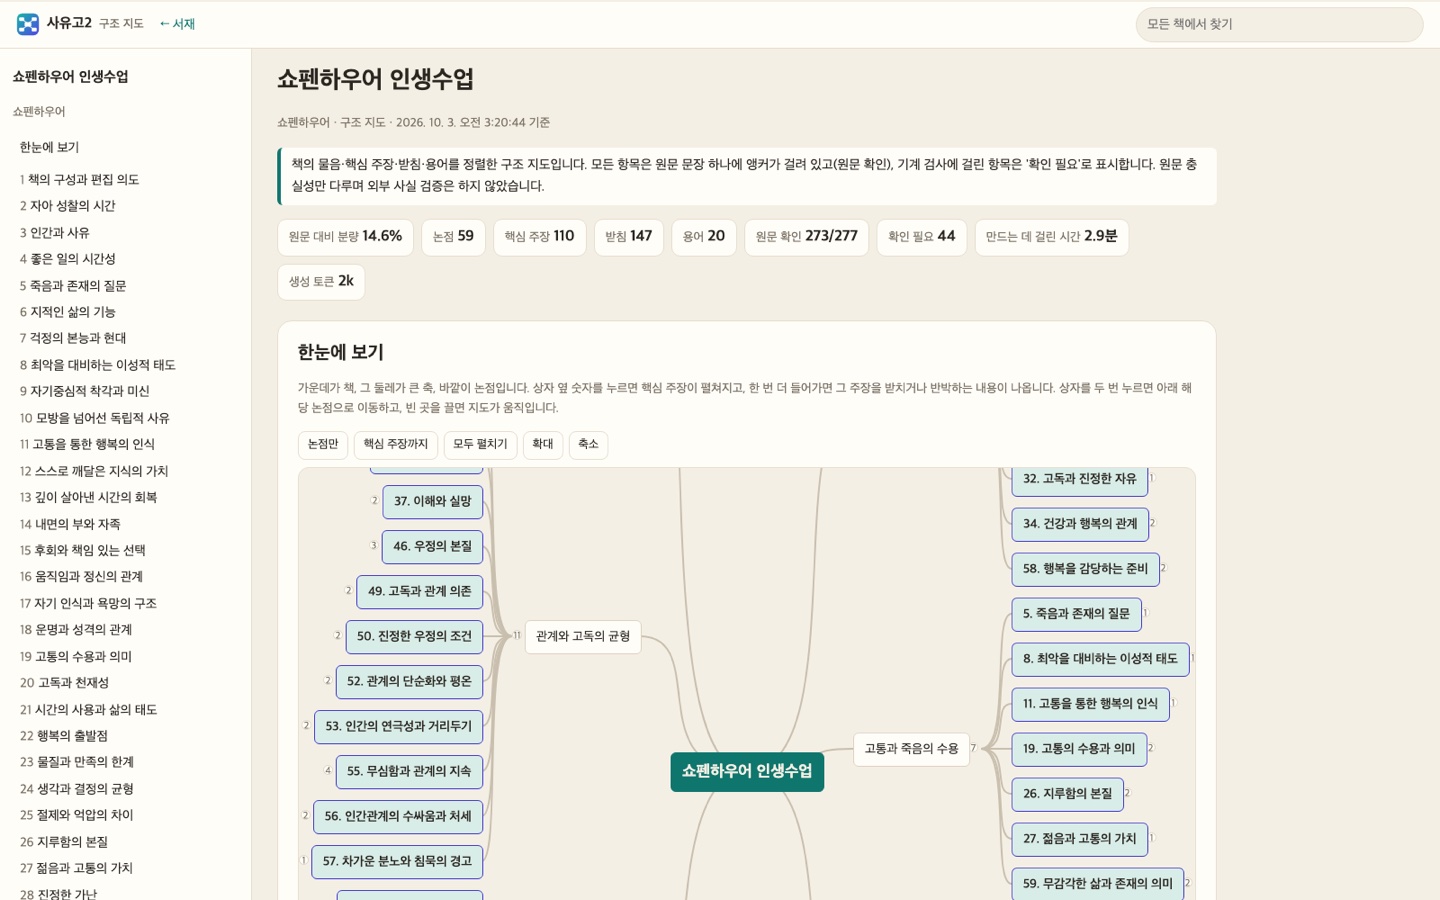
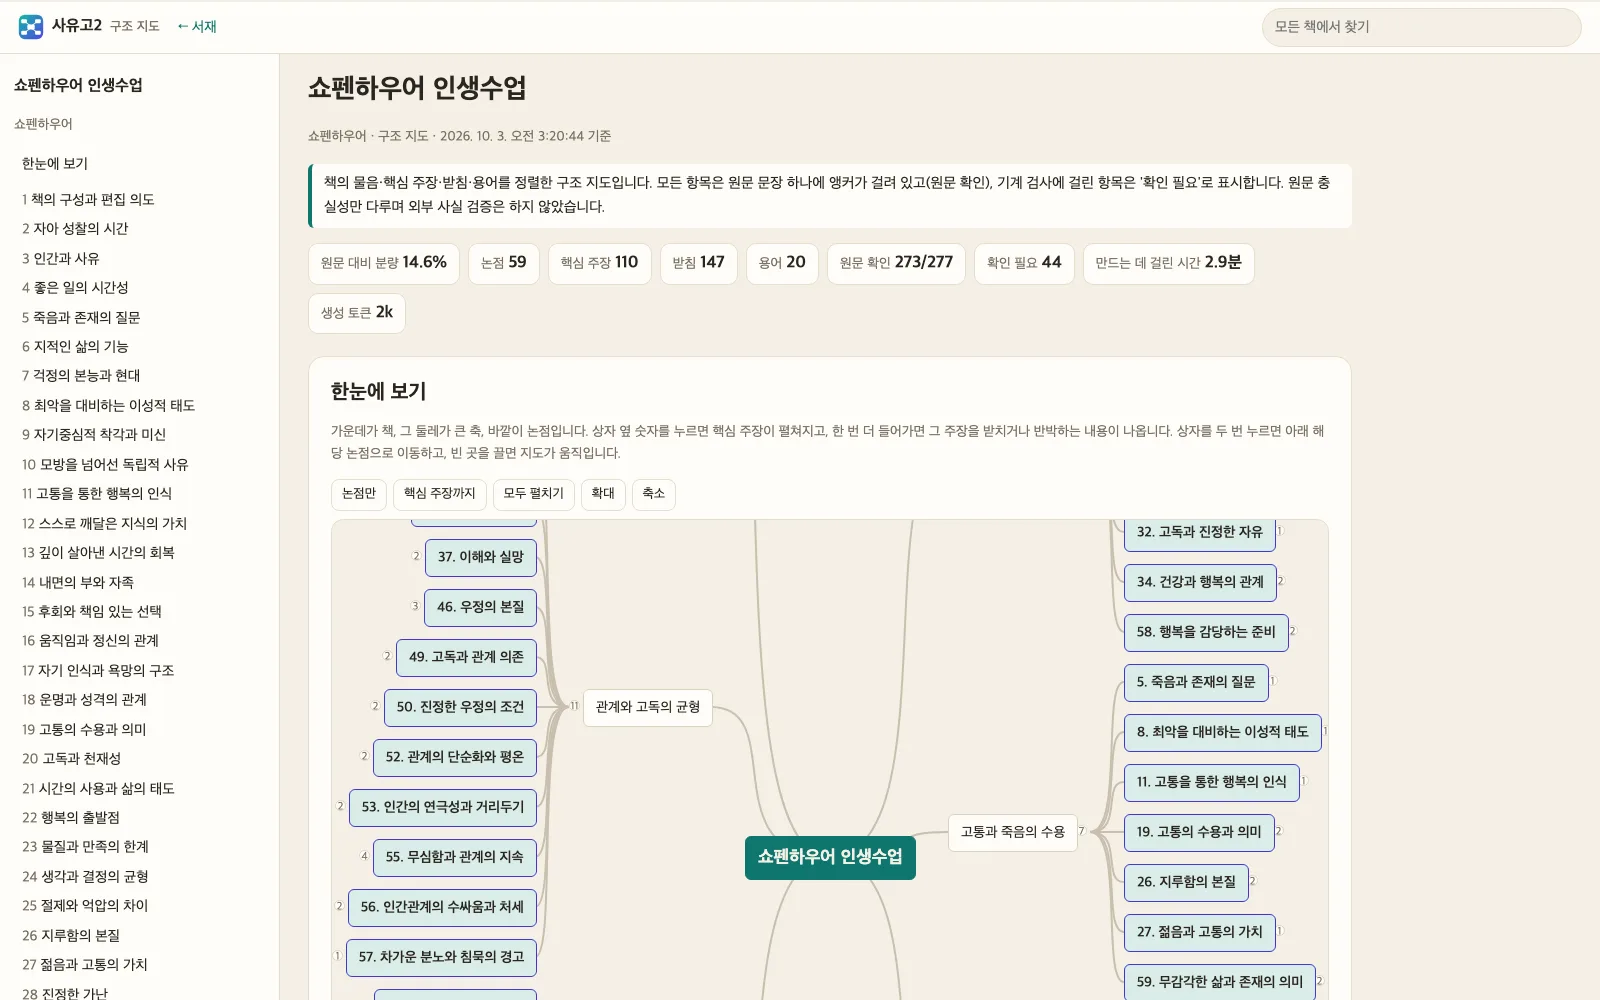
책을 열면 맨 위에 지도의 숫자가 먼저 나온다. 원문 대비 분량, 논점, 핵심 주장, 받침, 용어 수, 원문에 걸린 항목 수, 기계 검사에 걸려 확인이 필요한 항목 수, 만드는 데 걸린 시간이다. 그 아래 마인드맵은 가운데가 책, 그 둘레가 큰 축, 바깥이 논점이다. 상자 옆 숫자를 누르면 핵심 주장이 펼쳐지고, 한 번 더 들어가면 그 주장을 받치거나 반박하는 내용이 나온다.
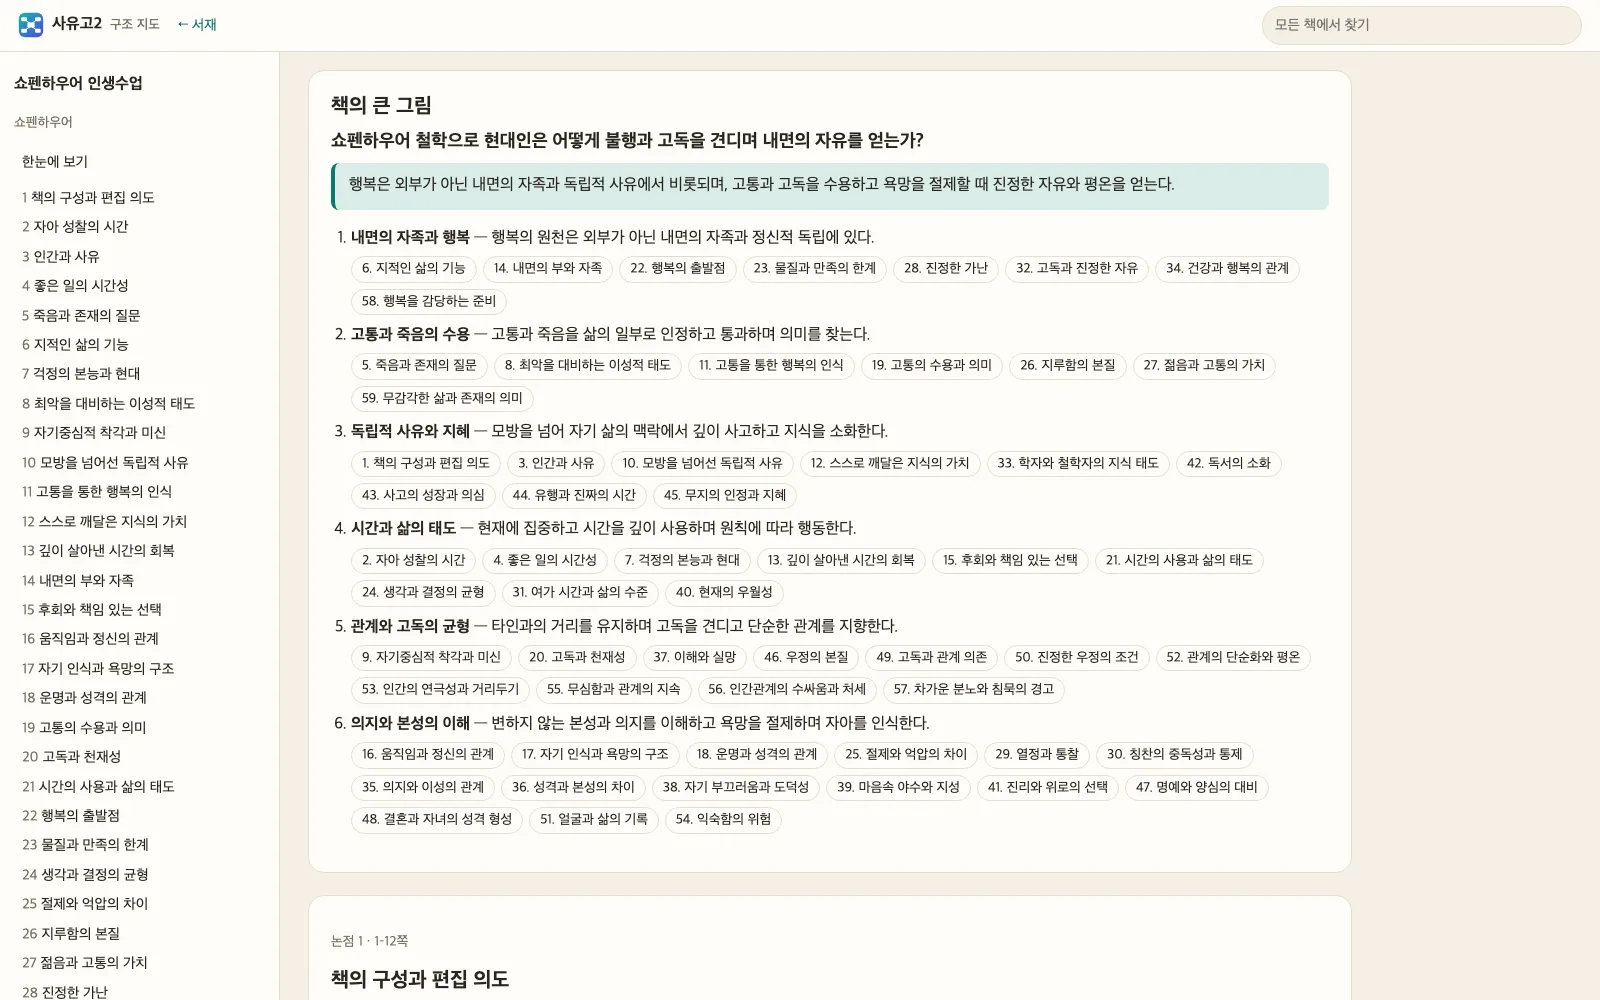
그다음은 책의 큰 그림이다. 이 책이 답하려는 중심 물음 하나와 그 답 한 문장, 그리고 큰 축마다 어떤 논점이 들어가는지가 이어진다. 책 한 권의 뼈대가 한 화면에 들어온다.
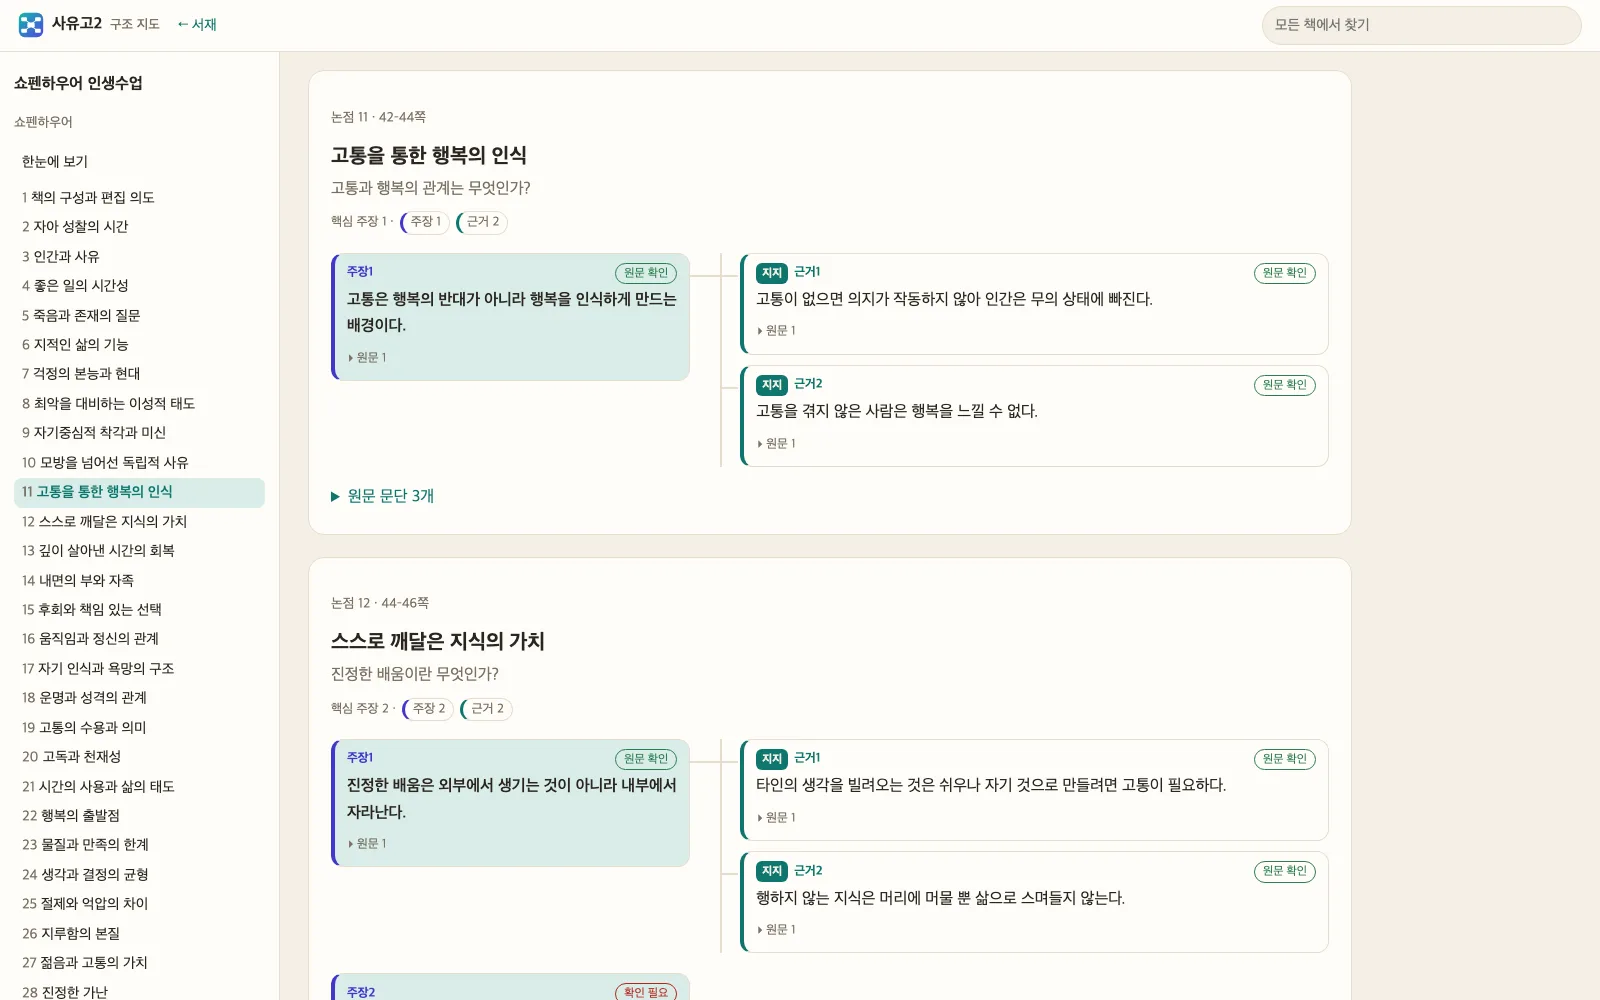
맨 아래는 논점마다의 논증 지도다. 왼쪽에 핵심 주장, 오른쪽에 그 주장을 받치는 근거가 상자로 이어지고, 상자마다 원문 몇 문단에서 왔는지 펼쳐 볼 수 있다. 논점 제목 아래에는 그 논점이 답하는 물음이 붙는다.
모든 항목은 원문 문장에 걸려 있다
지도의 항목은 모두 원문의 한 문장에 앵커로 걸린다. 앱이 그 앵커가 원문과 글자 그대로 맞는지 직접 확인하고, 맞으면 “원문 확인”을 붙인다. 모델이 쓴 문장을 그대로 믿지 않고 기계 검사를 한 번 더 거친다. 따옴표 안의 말이나 “누구에 따르면” 뒤의 말을 저자의 말로 적었는지, 옮긴이 주의 정의를 저자의 정의로 적었는지, 원문에 없는 원어나 숫자를 덧붙였는지를 본다. 걸린 항목은 한 번 고쳐 쓰고, 그래도 걸리면 “확인 필요”로 남긴다.
이 검사들은 첫 시험 책을 원문과 대조한 리뷰에서 나왔다. 다른 사상가의 말을 저자 말로 적은 화자 혼동, 원문에 없는 독일어를 덧붙인 일, 옮긴이 주를 저자 정의로 옮긴 일, 모델이 스스로 엮은 연결, 명제 여러 개를 한 항목에 묶은 일이었다. 지도는 원문에 충실한지만 다루고, 책 밖의 사실이 맞는지는 검증하지 않는다. 화면 맨 위에도 그렇게 적어 둔다.
스파크 두 대가 서재 전체를 지도로 바꾼다
지도는 스파크 두 대가 나눠 만든다. 2번 스파크는 늘 이 일을 하고, 1번 스파크는 영상 작업이 비어 있을 때만 빌려 쓴다. 맥의 관리 스크립트가 1분마다 1번의 상태를 보고, 영상 제작이나 예약된 리서치가 있으면 그쪽을 먼저 하게 돌려준다. 서버마다 책 네 권을 동시에 만들고, 짧은 책부터 차례로 처리한다. 지도가 이미 있는 책은 건너뛰니 언제 멈췄다 다시 켜도 이어서 간다.
맥 앱은 10분마다 스파크에서 새 지도를 받아 검색 색인을 다시 만든다. 사유고에 새 책을 등록하고 그 원본을 스파크로 보내면, 스파크는 10분 안에 대기열의 크기 순서 자리에 그 책을 끼워 넣는다. 10월 3일 새벽에는 그렇게 새 책 18권이 합류했다.
원본만 보내고 결과는 보기용으로 받는다
맥의 사유고는 그대로 두었다. 스파크로 가는 것은 책의 원문 텍스트와 서지와 정식 표지뿐이다. 페이지 사진이나 사유고가 만든 강의, 인용, 진도는 보내지 않는다. 원본은 해시로 확인해서 한 방향으로만 보내고, 같은 원본을 여러 번 보내도 결과가 같다. 스파크에서 만든 지도는 맥 앱이 보기용으로만 받아 온다. 사유고와 사유고2는 서로의 데이터를 고치지 않는다.
앱 아이콘과 색도 일부러 구분했다. 사유고의 남색과 금색 대신 청록과 남보라 아이콘을 쓰고, Dock에서 사유고 바로 옆에 둔다. 화면은 오래 읽어도 눈이 덜 피곤하도록 사유고와 같은 밝은 종이 색을 쓴다.
스파크의 Qwen3.8 Flash Next가 쓰고, 맥의 Bun 서버와 SQLite 색인이 읽는다
지도 만들기는 2번 스파크에서 도는 Bun 스크립트가 맡는다. 모델은 스파크의 로컬 서버에 올린 Qwen3.8 Flash Next이고, 생각 토큰을 끄고 서버당 동시 요청 16개로 돌린다. 맥 쪽은 launchd로 상시 도는 Bun 서버가 지도를 받아 SQLite 전문 검색 색인을 만들고, 두 글자 검색은 따로 처리한다. 책 화면의 상자형 마인드맵은 jsMind로 그리고, 화면 렌더러는 스파크 앱과 같은 것을 쓴다. 맥 앱은 Swift로 만든 창 안에 이 서버의 화면을 띄운다. 서버는 내 맥 안에서만 열린다.