로컬 TTS 뽑기 · 5화
Drama3는 맥스튜디오 4비트에서 가장 빨랐다: 음성 1초에 0.51초, 스파크 0.85초, 5090 3.36초
로컬 음성 모델 Drama3를 맥스튜디오(MLX 8비트·4비트), DGX Spark, RTX 5090에서 같은 원고와 같은 참조 음성으로 돌렸다. 음성 1초를 만드는 데 맥 4비트 0.51초, 스파크 0.85초, 맥 8비트 1.02초, 5090 3.36초가 걸렸다. 받아쓰기·숫자 발음·화자 유사도는 네 설정이 같은 범위였고, 차이는 속도와 준비 과정에서 났다.
Drama3를 맥스튜디오, DGX Spark, RTX 5090에 깔고 같은 문단을 같은 참조 음성으로 읽혔다. 음성 1초를 만드는 데 맥스튜디오 4비트가 0.51초로 가장 빨랐고 5090이 3.36초로 가장 느렸다. 받아쓰기·숫자 발음·화자 유사도는 기계마다 같은 범위였다.
4화에서는 Drama3로 영상 두 편의 나레이션을 만들었다. 이번 화는 기계별 비교다. Drama3는 Fish Audio가 10월 1일 공개한 350억 파라미터 MoE 음성 합성 모델이다. 토큰마다 30억 개가 활성화되고, 모델 파일은 41.5GB이며 전문가 가중치는 FP8로 배포됐다. 참조 음성과 그 대본을 넣으면 학습 없이 그 목소리로 읽는다. 공식 실행 경로는 리눅스 CUDA 서버이고 GPU 메모리 48GB 이상을 요구한다.
10월 19~20일에 세 원고를 돌렸다. 부르바키 결정론 문단(약 20초), 숫자 “1017”이 든 하이퍼사이클 P03(약 15초), 2026년·25억7500만 달러·24.9% 같은 숫자가 든 P07(약 17초)이다. 참조 음성은 부르바키 채널 원음 18.4초와 하이퍼사이클 채널 원음 16.3초이고 샘플링 설정도 같게 뒀다. DGX Spark는 공식 경로대로 vLLM-Omni 서버에 원본 FP8을 올렸다. 맥스튜디오(M4 Max 128GB)는 mlx-audio에 커뮤니티 MLX 변환본을, RTX 5090(32GB)은 윈도우용 커뮤니티 실행기에 원본 FP8을 올렸다.
맥 4비트가 음성 1초를 0.51초에 만들어 가장 빨랐다
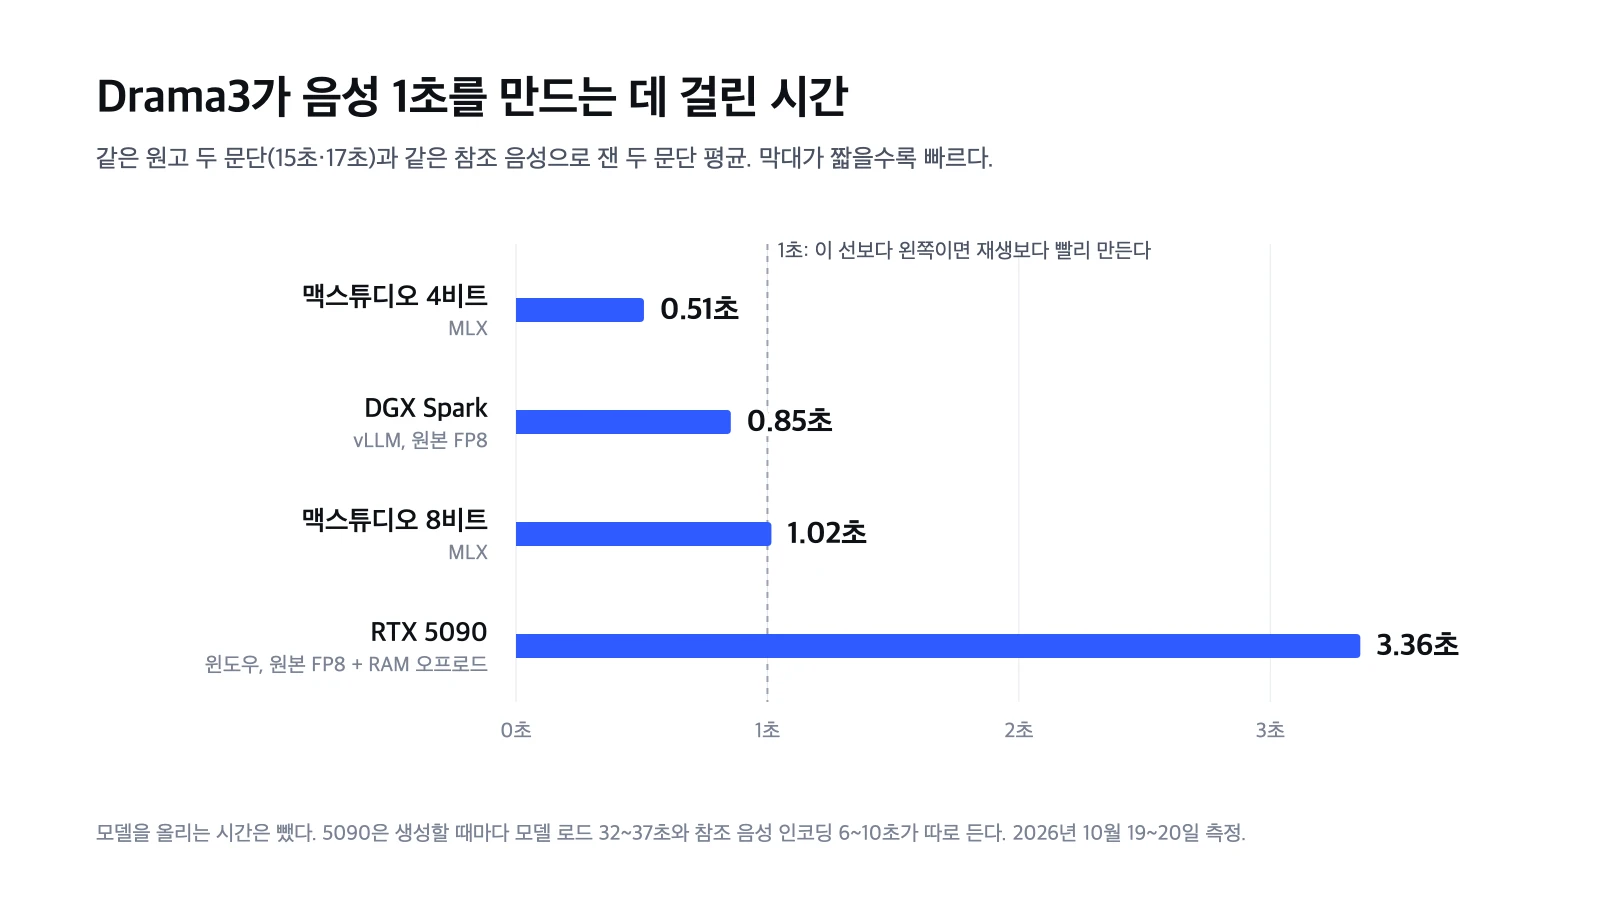
표의 숫자는 음성 1초를 만드는 데 걸린 생성 시간이다. 1보다 작으면 재생보다 빨리 만든다. 스파크는 떠 있는 서버에 요청을 보내고 파일을 받기까지의 시간이라 참조 음성 인코딩이 들어 있다.
| 기계 | P03 | P07 | 결정론 문단 | 생성 말고 드는 시간 | 최대 메모리 |
|---|---|---|---|---|---|
| 맥스튜디오 4비트 | 0.52초 | 0.50초 | 0.92초 | 실행마다 약 6초(첫 실행 39초) | 29.8~31.6GB |
| DGX Spark | 0.85초 | 0.86초 | 0.85~0.93초 | 서버 기동 한 번 약 10분 | 재지 않음 |
| 맥스튜디오 8비트 | 0.98초 | 1.05초 | 2.36초 | 실행마다 약 13초(첫 실행 27초) | 48.6~50.0GB |
| RTX 5090 | 3.34초 | 3.38초 | 3.80~4.02초 | 실행마다 38~47초 | GPU 25.4GiB, RAM 21.4GiB |
맥에서는 4비트가 8비트보다 두 배 빨랐다. 토큰마다 읽을 가중치가 절반이기 때문으로 보인다. 맥의 결정론 문단은 두 번 다 배치의 첫 실행이었고 느린 원인은 가르지 못했다.
5090은 모델이 GPU 메모리에 다 들어가지 않아 3.36초가 걸렸다
5090은 가중치 24.9GiB를 GPU에 두고 전문가 가중치 12.0GiB는 시스템 RAM에 두었다가 필요할 때마다 가져왔다. 문단 하나에 옮긴 양이 184~310GiB였다. GPU 예산을 26GiB에서 30GiB로 늘리자 같은 문단이 76.6초에서 65.4초로 15% 줄었다. 실행마다 모델 로드 32~37초와 참조 음성 인코딩 6~10초가 더 들어서 20초짜리 문단 하나에 프로세스 전체로 120~134초가 걸렸다.
받아쓰기·숫자 발음·화자 유사도는 네 설정이 같은 범위였다
Whisper large-v3로 받아쓴 결과는 모두 원고 내용과 맞았다. 숫자 6곳은 발음 검사기(정답을 주지 않는 받아쓰기와 음향 대조)로 봤다. 네 설정 모두 5곳이 기계 검사를 통과했고, “1017(일공일칠)“은 모두 판정 불가였다. 받아쓰기가 매번 “일곱 일질”이나 “일공 일질”로 들었는데, 발음 문제인지 인식기 한계인지는 가리지 못했다. 맥 8비트와 스파크 원음 검사는 이 글을 쓰며 같은 검사기로 돌렸다.
화자 유사도(ECAPA)는 자기 참조 음성과 0.80~0.89였다. 기계별 범위는 스파크 0.846~0.887, 5090 0.832~0.885, 맥 8비트 0.844~0.862, 맥 4비트 0.801~0.868로 서로 겹쳤고 다른 채널 참조와는 0.46~0.66이었다. 정밀도를 줄인 4비트도 기계 검사에서는 차이가 나지 않았다. 사람이 듣고 판정한 결과는 아니다.
10초 넘게 끊긴 생성은 스파크에서 24번 중 한 번 나왔다
스파크에서 혼자 읽는 낭독을 24번 만드는 동안 한 번은 첫 문장만 읽고 16.6초 무음으로 끝났다. 다시 돌리자 정상으로 나왔다. 5090 5번, 맥 6번에서는 이런 끊김이 없었지만 횟수가 적어 기계 차이로 보기는 어렵다. 표에 쓴 결과물 12개의 가장 긴 쉼은 0.65~1.43초로, 참조 음성의 가장 긴 쉼(1.41~1.42초)과 비슷했다.
실제 원고에서는 비교 원고에서 보지 못한 긴 쉼이 나왔다. 10월 20일 맥 8비트로 만든 영상 나레이션 18문단 중 3문단에서 2초 넘는 쉼이 9번 나왔고 가장 긴 쉼은 4.23초였다. 이 쉼은 0.65초로 줄였다. 원인이 기계인지 원고나 참조 음성인지는 가르지 못했다.
설치는 윈도우 5090이 14분으로 가장 짧았다
5090은 커뮤니티 윈도우 실행기를 PowerShell 스크립트로 깔았고 WSL은 필요 없었다. 체크포인트 약 40GB를 받는 11분 56초를 포함해 13분 51초가 걸렸다. 다만 git 대신 zip으로 받아 표시 파일 하나가 빠지는 바람에 첫 시험 4개가 모두 실패했고 ComfyUI가 잡고 있던 GPU 메모리를 25,788MiB에서 1,692MiB로 비워야 했다.
스파크는 vLLM 0.31과 vLLM-Omni로 Docker 이미지를 만드는 데 빌드 실패를 고치며 약 28분이 걸렸다. 서버는 실행 인자 오류와 기본 대기 300초 초과로 두 번 꺼졌고 대기를 1,800초로 늘린 세 번째 시도에서 약 10분 만에 떴다. Qwen을 내린 뒤 서버가 뜨기까지 17분이었다.
맥스튜디오는 PyPI의 mlx-audio 0.5.9에 Drama3가 없어서 GitHub 최신판을 깔았다. 4비트(22GiB)와 8비트(39GiB)를 함께 받는 데 각각 1시간 15분과 약 2시간이 걸렸다.
나레이션 생성은 맥스튜디오가 맞았다: 다른 기계를 멈추지 않아도 된다
10월 20일 부르바키 영상 나레이션은 맥 8비트로 만들었다. 본편 18문단 가운데 시험용으로 먼저 만든 1문단을 뺀 17문단은 원음 299.3초를 482.7초에(첫 문단의 모델 로드 포함), 쇼츠 8문단은 51.6초를 45.4초에 만들었다. 본편이 비교 때보다 느린 이유는 따로 재지 않았다.
스파크는 서버를 띄워 두면 요청마다 바로 만든다. 10월 19일 하이퍼사이클 영상 11문단(원음 143.9초)은 쉼 기준에 걸려 다시 만든 3번을 포함해 14번 요청에 165.5초가 걸렸다. 대신 서버가 떠 있는 동안 그 스파크의 Qwen 작업이 멈춘다. 동시 요청 처리량은 아직 재지 않았다. 5090은 맥과 스파크가 모두 바쁠 때 쓸 대안이다.
배운 것: 기계를 바꿔도 기계 검사 결과는 같았고 속도와 준비 시간이 달라졌다
화자 유사도는 한 기계 안의 편차가 기계 사이 차이만큼 컸다. 그래서 기계는 속도, 준비 시간, 그동안 멈춰야 하는 다른 작업을 보고 고른다. 가장 빠른 GPU를 단 5090이 가장 느렸던 것은 32GB에 모델이 다 들어가지 않아 생성 내내 가중치를 옮겼기 때문이다.