레오폴드 챗봇 개발로그 · 3화
레오폴드 챗봇이 HTML 보고서를 쓰고, 그 보고서가 2천만원 모의 포트폴리오가 됐다
10월 4일 밤 채팅창에 채팅·심층리서치·보고서 제작 세 모드를 붙였다. 첫 투자 보고서는 현금 비중부터 서로 맞지 않아서, 후보를 먼저 고르고 숫자는 코드가 검산하게 바꿨다. 다음 날 그 보고서를 한·미 2천만원 모의 포트폴리오 대시보드로 연결했다.
2화는 레오폴드, 메르, 케빈 워시 셋이 모인 투자자 라운지에서 끝났다. 셋 다 대화는 잘했지만 남는 게 없었다. 말은 채팅창에서 흘러가고, 그 판단이 맞았는지 나중에 확인할 방법이 없었다. 이 글은 10월 4일 밤부터 5일 낮까지, 대화가 보고서가 되고 보고서가 포트폴리오가 된 기록이다.
10월 4일 밤, 채팅창에 채팅·심층리서치·보고서 제작 세 모드를 붙였다
밤 10시 21분에 이렇게 보냈다. 보고서 수준이 왜 이래, HTML로 만들어야지. 모델은 GPT Astra, Claude Opus 5.5까지 다 추가하고, 채팅, 심층리서치, 보고서 제작(HTML) 셋 중에 고를 수 있게 해. 보고서 제작은 HTML이 원칙이다.
입력창 아래에 작업 선택이 생겼다. 1번 채팅, 2번 심층리서치, 3번 보고서 제작이다. 모델은 세 친구가 같은 목록 18개에서 고르고, 고른 작업과 모델은 대화방마다 따로 저장된다. 보고서 모드에서는 고른 모델이 조사부터 작성까지 맡는다. 모델이 HTML을 직접 쓰지는 않는다. 모델은 구조화된 내용만 돌려주고, 서버가 그 내용을 이스케이프해 목차, 표, 출처, 한계가 들어간 HTML로 저장한다. 모델이 쓴 스크립트는 실행하지 않는다. 응답이 잘렸거나 등록되지 않은 출처를 인용하면 보고서가 완성된 것으로 치지 않는다. 채팅에는 열기와 내려받기 버튼이 붙은 보고서 카드가 남는다.
같은 날 밤 모델마다 쓸 계정도 고를 수 있게 했다. Codex와 Claude 계정을 두 개씩 등록해 두고, 한 계정이 한도에 걸려도 다른 계정으로 몰래 넘어가지 않는다.
첫 투자 보고서는 현금 비중부터 서로 맞지 않았다
다음 날 아침 10시 25분, 한·미 각각 1,000만원으로 포트폴리오를 짜 달라고 해서 받은 보고서를 다시 보냈다. 보고서 수준이 좀 너무 낮은데?
형식보다 내용이 문제였다. 본문은 현금을 15% 남긴다고 하는데 표에는 25%였다. 종목당 상한이 200만원이라면서 한 종목에 300만원을 배정했다. 미국 쪽은 “대형주 1~2종”으로 비워 두고, 환율과 현재가 확인은 다시 나에게 넘겼다. 원인을 따라가 보니 보고서가 읽은 재료부터 틀렸다. 포트폴리오 후보 대신 그날 등락률이 가장 큰 종목 네 개를 자료로 가져와서, 급등한 소형주 이야기가 끼어들고 정작 필요한 기업 분석은 비어 있었다. 출처 목록은 검사했지만 본문의 인용 번호가 맞는지는 보지 않았다.
후보부터 고르고, 숫자는 코드가 검산하게 바꿨다
투자 보고서만의 경로를 새로 만들었다. 다섯 단계다.
- 요청에 맞는 후보를 최대 8개 먼저 고른다.
- 후보마다 시세와 지표, 원·달러 환율, 등록된 기업의 공식 실적 자료 발췌를 모은다.
- 모델이 종목별 판단, 진입·축소·청산 조건, 반증 시나리오를 구조화해 쓴다.
- 배정액, 정수 주 수, 원화 환산액, 시장별 잔액, 종목당 상한은 코드가 소수점 오차 없이 다시 계산한다.
- 같은 모델이 본문과 표가 어긋나는 곳이 없는지 한 번 더 대조한다.
종목당 상한이나 시장별 예산을 넘거나 본문 인용 번호가 출처에 없으면 보고서를 저장하지 않는다. Sonnet 5.5로 다시 돌리니 후보 선정 9.5초, 작성 168초가 걸렸다. 마지막 대조에서 “이 종목은 상한 비중이 아니다”라는 문장이 실제 배정표와 어긋난 것을 비롯해 네 문단이 고쳐졌다. 결과는 15절, 약 56KB짜리 보고서였다. 후보 두 개는 공식 자료를 확보하지 못했는데, 그 사실은 보고서의 한계 절에 그대로 남겼다. 이 대조는 모델이 자기 글을 다시 읽는 것이지 독립된 사실 검증은 아니라는 것도 함께 적었다.
“실제 대시보드로 연결하자”는 말에 보고서가 포트폴리오 장부가 됐다
11시 56분, 그 보고서를 열어 둔 채로 말했다. 이걸 실제 대시보드로 연결해서, 실제 매매를 했다고 가정하고(실제 매매일 수도 있고) 추적하고 피드백하는 과정까지 하자. 리밸런싱도 할 수 있는 거고.
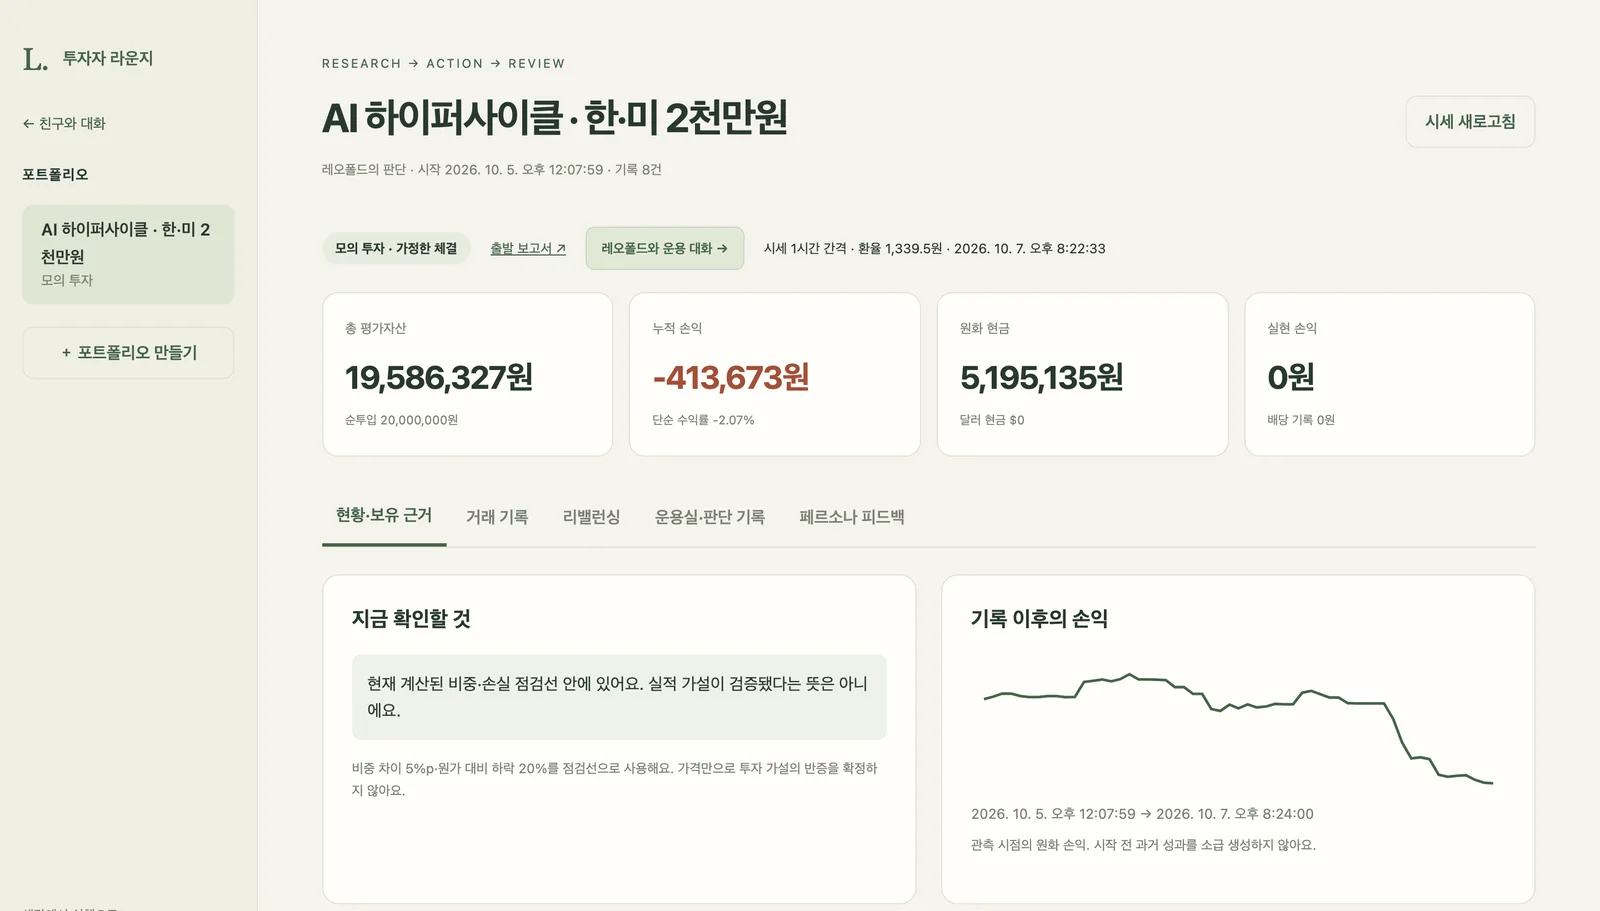
20분 뒤 대시보드가 열렸다. 보고서의 구성을 “AI 하이퍼사이클 · 한·미 2천만원”이라는 모의 포트폴리오로 등록했다. 한국 세 종목, 미국 두 종목을 보고서의 가격과 환율로 정수 주만큼 샀다고 가정하고, 남은 약 520만원은 현금으로 뒀다. 실제 주문은 하지 않았다. 등록한 순간부터의 시세만 쌓고, 등록 전의 수익률을 거꾸로 만들어 내지 않는다.
장부는 매수, 매도, 입출금, 배당, 환전, 분할을 기록한다. 원화와 달러 현금을 따로 두고, 수수료를 넣은 평균 단가와 원화 기준 손익을 계산한다. 현금이 모자라거나 가진 것보다 많이 팔려고 하면 거래 전체를 거부하고, 같은 요청이 두 번 들어와도 한 번만 반영한다. 모의 장부와 실제 체결을 기록하는 장부는 섞이지 않는다.
시세와 환율은 서버가 1시간마다 받아 두고, 화면은 받아 둔 값만 읽는다. 비중이 목표에서 5%p 넘게 벗어났는지, 원가 대비 20% 넘게 떨어진 종목이 있는지, 시세가 오래됐는지는 코드가 본다. 가격만 보고 투자 가설이 틀렸다고 판정하지는 않는다. 레오폴드의 피드백은 버튼을 눌렀을 때만 모델을 불러서, 시세를 볼 때마다 토큰이 나가지 않게 했다.
리밸런싱은 목표 비중을 바꾸면 사고팔 주 수와 남을 현금을 먼저 미리 보여 주고, 반영 버튼을 눌러야 장부에 들어간다. 미리보기는 10분이 지나면 다시 계산해야 한다. 모의 장부는 가정 체결로 반영하고, 실제 장부는 목표만 저장한 뒤 실제로 체결한 내용을 내가 직접 입력한다. 증권사 주문은 연결하지 않았다.
배운 것
보고서 수준이 낮았던 건 문장력 탓이 아니었다. 엉뚱한 재료를 읽었고, 모델이 쓴 숫자를 아무도 다시 계산하지 않았다. 숫자는 코드가 맞추고 모델은 판단과 이유를 쓰게 나누자 보고서끼리 모순이 사라졌다.
그리고 보고서를 끝이 아니라 출발점으로 만들었다. 보고서가 장부가 되자 그날의 판단이 시간이 지나 어떻게 됐는지 볼 수 있게 됐다. 다음 화는 레오폴드가 이 장부를 직접 맡아 운용하고, 매매할 때마다 나에게 결재를 받는 이야기다.