위키룸 활용 · 1화
금융위기 60건 관점 지도: 책 650권 원문 21만 쪽을 전수 스캔했다
위키룸에 넣은 사유고 원문 21만 쪽을 전수 스캔하고, 책마다 위기를 어떤 관점으로 서술하는지 AI로 정리했다. 새벽 네 시간 작업이다.
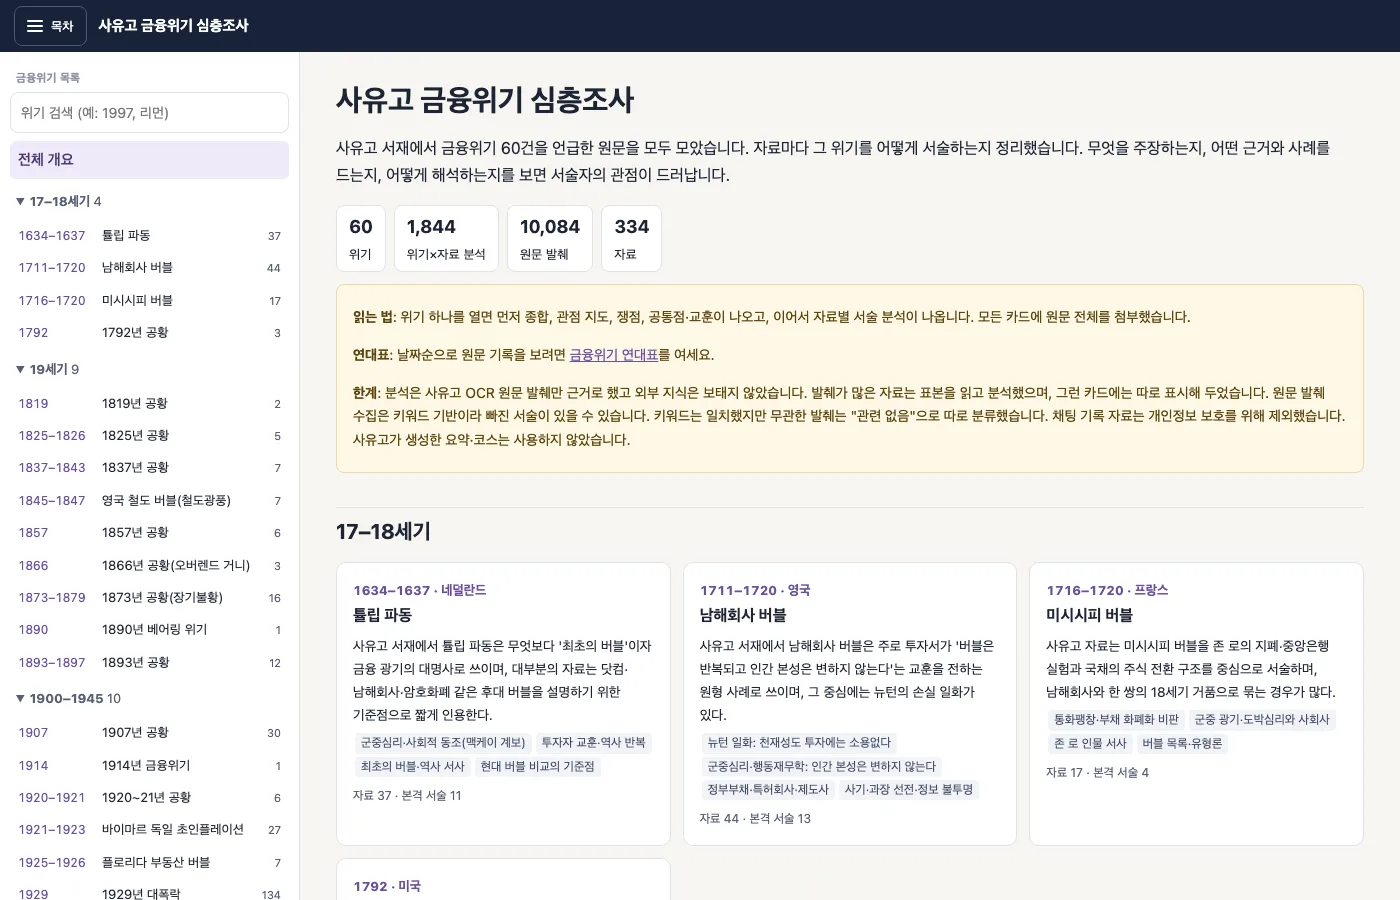
금융위기 연대표를 하나 만들고 싶었다. 인터넷에 있는 연대표는 많다. 내가 궁금했던 건 조금 다른 것이었다. 내 서재에 있는 책들은 튤립 파동이나 리먼 사태를 각각 어떻게 이야기하는가. 같은 사건을 두고 어떤 책은 탐욕의 교훈으로, 어떤 책은 규제 실패로, 어떤 책은 과장된 신화로 쓴다. 그 차이를 한 장에 펼쳐 보고 싶었다.
재료는 사유고다. 찍어 둔 종이책과 강의 자료를 OCR해서 물어볼 수 있게 만든 개인 서재인데, 지금 650개 자료, 21만 3,804쪽이 들어 있다. 이 원문을 위키룸에 넣어 두었고, 연대표와 심층조사는 위키룸에서 만들었다. 위키룸이 원래 하는 일, 흩어진 자료를 원문 근거가 붙은 문서로 엮는 일을 서재 전체 규모로 해 본 셈이다. 9월 30일 새벽 4시 전에 시작해서 7시 반쯤 끝났다.
요약본이 아니라 원문을 읽혔다
사유고에는 이미 책마다 AI가 만든 요약·강의·챕터 분석이 있다. 이번에는 그걸 한 줄도 쓰지 않았다. 요약은 이미 한 번 모델을 거친 문장이라 거기서 다시 뽑으면 틀린 것이 두 번 증폭된다. 근거는 OCR 원문으로만 잡았다.
순서는 이랬다.
- 발견. 원문 전체에서 “연도 + 위기어”가 붙어 나오는 패턴(예: “1997년 외환위기”, “1929년의 대공황”)을 셌다. 서재에 실제로 등장하는 위기가 무엇인지 먼저 알아야 목록을 짤 수 있다.
- 카탈로그. 그 결과로 튤립 파동(1634)부터 SVB 사태(2023)까지 60개 사건군과 별칭 목록을 만들었다. 리먼, 서브프라임, 글로벌 금융위기는 한 사건으로 묶는 식이다.
- 전수 스캔. 650개 자료의 모든 쪽을 문장 단위로 훑어 1만 5,411개 문장을 찾았다. 여기까지는 모델이 없다. 정규식과 파이썬뿐이다.
- 발췌 묶기. 위기 하나 × 자료 하나를 한 단위로 보고, 걸린 문장 앞뒤 두 문장씩 붙여 발췌를 만들었다. 단위 2,107개, 발췌 1만 572개가 나왔다.
모델이 들어오는 건 그다음부터다.
서브에이전트 50개가 “이 책은 이 위기를 어떻게 쓰는가”를 적었다
2,107개 단위를 50개 묶음으로 나눠 서브에이전트 50개에 맡겼다. 지침은 한 문서로 고정했다. 핵심은 이 문장이다. 분석 대상은 위기 자체가 아니라 이 서술자가 이 위기를 어떻게 다루는가다.
그래서 각 단위마다 적는 칸이 정해져 있다.
- 언급 방식: 본격 서술 / 사례 인용 / 비교·열거 / 단순 언급
- 서술 방식, 핵심 주장, 근거로 든 수치·사실, 사례, 해석
- 서술자 관점 (예: 군중심리, 신용팽창, 규제 비판, 투자자 교훈, 수정주의)
- 핵심 인용 1~3개
규칙도 몇 개 박았다. 발췌에 없는 사실은 보태지 않는다. 외부 지식을 쓰지 않는다. 저자의 말과 저자가 인용한 남의 말을 구분한다. 역자 주나 인터뷰이 발언이면 누구 말인지 적는다. 키워드는 걸렸지만 다른 이야기면 “관련 없음”으로 표시한다.
마지막 규칙이 생각보다 많이 일했다. 2,107개 중 263개가 관련 없음으로 빠졌다. 대부분 별칭 오탐이었다. “리먼”이 해리먼이나 프리먼 안에 들어 있었고, SVB나 FTX가 다른 문맥의 약어로 걸렸다. 정규식만으로 연대표를 만들었다면 이 263개가 그대로 섞였을 것이다.
인용은 한 글자도 바꾸지 않았는지 기계가 검사한다
모델이 쓴 결과물에서 제일 위험한 곳은 인용문이다. 그럴듯하게 다듬어 쓰기 쉽다. 그래서 인용은 발췌 문자열을 공백 외에는 그대로 복사하라고 하고, 검사 스크립트가 원문과 대조했다. 형식 오류, 단위 누락, 인용 불일치가 0이 될 때까지 에이전트가 스스로 고쳤다. 앞 단계 연대표에서 뽑은 대표 문장 1,023개도 원본 쪽과 재대조해 전부 일치했다.
위기별로 “관점 지도”를 다시 합쳤다
단위 분석 1,844개를 위기별로 모아 서브에이전트 11개가 종합했다. 여기서도 목표는 위기 요약이 아니다. 내 서재가 이 위기를 어떤 관점들로 나눠 서술하는지 보여 주는 지도다. 책마다 수치나 날짜가 다르면 하나로 합치지 말고 나란히 적게 했다.
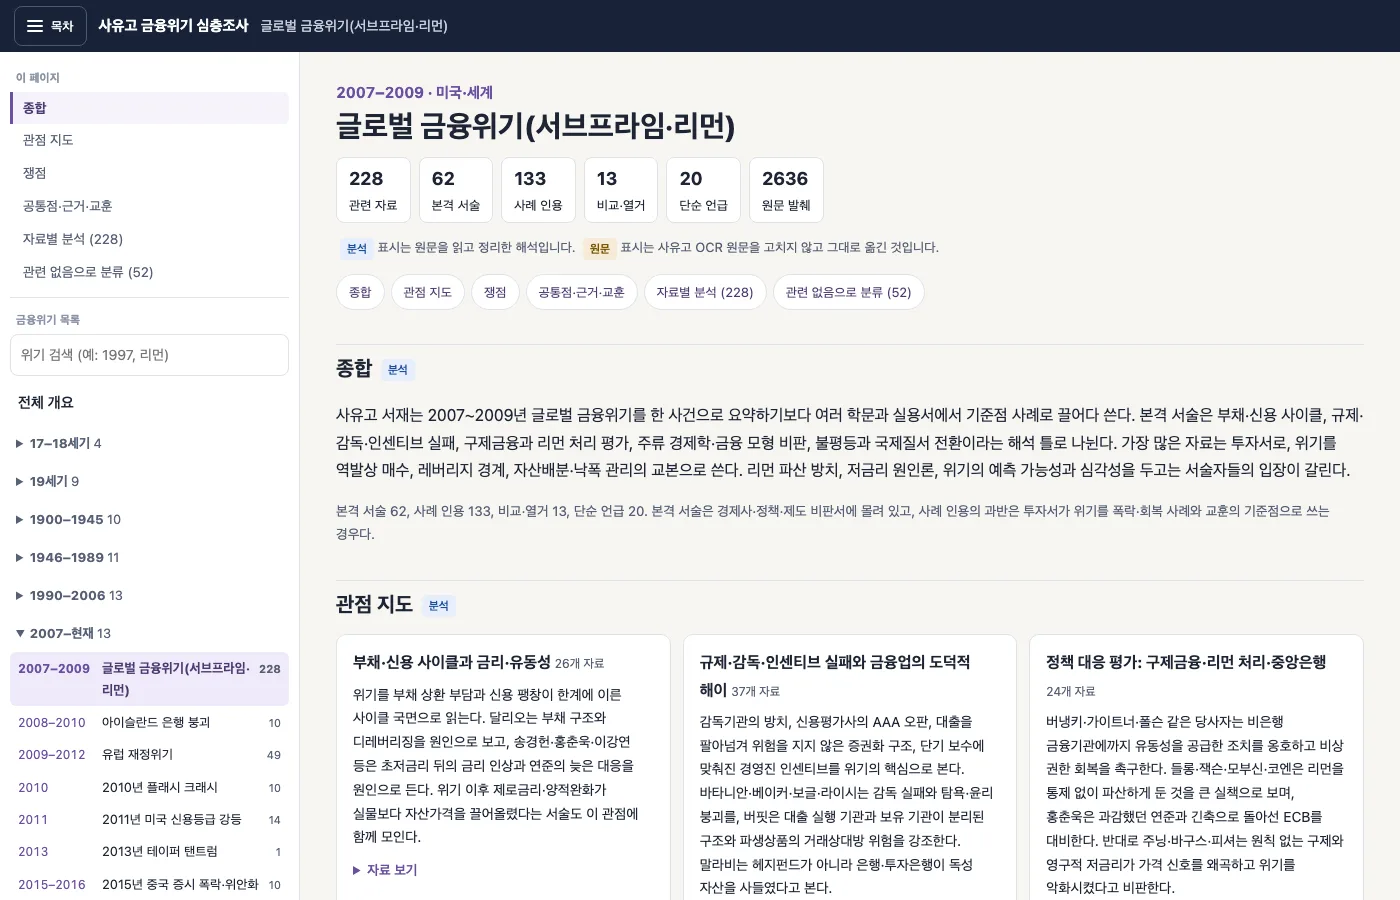
글로벌 금융위기가 제일 컸다. 관련 자료 228개가 나왔고 관점은 여덟 갈래로 묶였다. 부채·신용 사이클, 규제·인센티브 실패, 구제금융과 리먼 처리 평가, 주류 경제학과 금융 모형 비판, 복잡계와 전염, 불평등과 국제질서, 그리고 가장 큰 덩어리인 투자자 교훈(76개)이다. 내 서재에서 2008년은 무엇보다 투자서가 “폭락장에서 살아남는 법”의 기준점으로 쓰는 사건이었다. 본격적으로 원인을 따지는 자료는 62개였고, 사례로 끌어다 쓰는 자료가 133개였다.
재미있는 건 쟁점 칸이다. 같은 서재 안에서 입장이 갈리는 지점이 여덟 개 나왔다. 몇 개만 옮기면 이렇다.
- 리먼을 파산하게 둔 건 실책인가, 무분별한 구제가 더 문제인가
- 연준의 저금리가 거품의 주범인가, 과장된 원인론인가
- 위기는 예측할 수 있었나, 사후확신인가
- 대공황 이후 최악의 위기인가, 빠르게 회복된 전형적 공황인가
- VaR 같은 금융 모형이 위기를 키웠나, 모형을 점검하지 않은 태도가 문제인가
튤립 파동도 비슷했다. 서른일곱 개 자료 대부분은 “최초의 버블”로 짧게 인용하고 지나가는데, 몇 권은 실물 피해가 작았고 통념이 부풀려졌다는 수정주의 쪽에 선다. 네덜란드 경제가 입은 타격의 크기를 두고 책끼리 정면으로 부딪힌다. 한 권씩 읽을 때는 보이지 않던 대립이다.
결과물
HTML 한 벌이다. 첫 화면에 시대별 위기 60건 카드가 있고, 위기 페이지마다 종합, 관점 지도, 쟁점, 공통점·반복 근거·교훈, 자료별 분석 카드가 이어진다. 관점 칩을 누르면 그 관점에 속한 책 카드로 간다. 카드에는 AI 분석(파란 배지)과 OCR 원문(노란 배지)을 색으로 갈라 두었다. 모델이 쓴 말과 책에 적힌 말이 섞여 보이지 않게 하려는 것이다.
원문 발췌는 카드마다 접힌 채 전부 붙어 있다. 그래서 이 HTML은 내 맥에서만 연다. 책 원문이 1만 개 넘게 들어 있어서 공개할 수 없다. 이 글에 캡처만 싣고 책 인용을 하나도 넣지 않은 이유도 같다. 공개할 수 있는 건 구조와 방법, 그리고 AI가 원문을 읽고 새로 쓴 분석 문장까지다. 채팅 기록처럼 사유고에 섞여 있던 개인 자료는 결과물에서 아예 뺐다.
모바일 대응에 생각보다 시간이 들었다. 폰에서 열었더니 목차를 눌러도 이동하지 않았다. 파일 미리보기 앱이 스크립트와 앵커 링크를 막고 있던 것으로 보인다. 결국 스크립트 없이도 목차가 동작하도록 CSS 라디오 버튼으로 절을 바꿔 보여 주는 방식을 따로 만들었다.
한계
- 수집은 키워드 기반이라 별칭을 모르는 서술은 빠진다. 1890년 베어링 위기는 원문 근거가 한 문장뿐이라 연대표에서 뺐다.
- 발췌가 아주 많은 책(대공황·IMF 외환위기 전문서 같은)은 2,500자 표본만 읽고 분석했다. 그런 카드에는 표본 분석이라고 표시해 두었다. 원문은 전부 붙어 있다.
- 관점 분류와 해석은 모델이 했다. 인용 일치는 기계로 확인했지만 해석이 맞는지 사람이 원문과 대조해 검수하지는 않았다.
배운 것
모델에게 서재를 통째로 읽히지 않았다. 정규식으로 전수 스캔해서 범위를 좁히고, 단위를 작게 잘라 에이전트에게 나눠 주고, 모델이 쓴 결과는 스크립트로 검사했다. 모델이 한 일은 “이 문단에서 저자는 무엇을 주장하는가”를 읽는 것 하나다. 그 한 가지를 2,107번 시킨 것이다.
그리고 요약이 아니라 관점을 물으니 쓸모가 달라졌다. 금융위기 요약은 어디에나 있다. 내 서재의 책들이 2008년을 두고 어디서 갈라서는지는 여기에만 있다.