위키룸 활용 · 2화
양극화 심층리서치 7편: 사유고 682개 자료로 문단마다 근거를 달았다
위키룸에 넣은 사유고 682개 자료로 양극화 심층리서치를 만들었다. 문단마다 근거 원문 번호가 붙고, 서재에 없는 것은 없다고 적는다.
금융위기 관점 지도를 만든 날 저녁, 같은 방식으로 주제 하나를 더 파 봤다. 이번 주제는 양극화다. 사건 목록이 있는 금융위기와 달리 양극화는 경계가 흐릿하다. 소득 격차, 일자리, 정치, 소셜미디어, 세대 문제가 한 단어에 다 들어 있다. 그래서 연대표 대신 보고서를 쓰게 했다.
재료는 이번에도 사유고다. 찍어 둔 책과 강의 자료를 OCR한 서재로, 그사이 682개 자료, 22만 3,821쪽으로 늘었다. 이 원문을 위키룸에 넣어 두고 위키룸에서 작업했다.
1차: 키워드로 훑었더니 빈 곳이 보였다
처음에는 금융위기 때처럼 키워드 전수 스캔부터 했다. “양극화”라는 단어는 서재 137권에 781번 나온다. 여기에 분극, 승자독식, 부익부 빈익빈, 이중구조, 중산층 붕괴, K자, 에코 체임버, 필터 버블 같은 말을 더해 1,214개 문장을 모았다. “극화”는 각색이라는 뜻일 때를 빼고, “양극단”은 정치·계층·소득 같은 말 근처에 있을 때만 넣었다.
서브에이전트 8개가 자료 211개를 읽고 168개를 관련 있다고 판정했다. 무관한 43개는 대부분 물리학의 분극이나 빛의 편광이었다.
1차 결과를 보니 한계가 분명했다. “양극화”라는 단어를 쓰지 않고 불평등이나 격차만 말하는 서술은 키워드에 걸리지 않는다. 피케티를 다룬 책이 “양극화”라는 단어를 몇 번 쓰는지는 중요하지 않다.
2차: 서재에 질문 90개를 던졌다
그래서 2차에서는 방식을 바꿨다. 양극화를 하위주제 일곱 개로 나눴다.
- 소득·부·자산
- 노동·일자리
- 기업·시장·산업
- 정치·이념
- 집단심리·미디어
- 지역·세대·교육·계층
- 국제질서·국가 간
하위주제마다 연구 질문을 11~16개씩, 모두 90개 만들었다. 소득 쪽은 이런 질문이다. 자본수익률이 성장률보다 높으면 왜 부가 쏠리는가. 양적완화와 저금리가 자산 격차를 키웠는가. 불평등은 성장의 자연스러운 결과라는 반론은 무엇인가. 질문은 보고서 목차(정의, 측정, 역사, 원인, 결과, 논쟁, 사례, 한국, 해법, 투자 함의)를 고르게 덮도록 짰다. 반론을 묻는 질문을 일부러 넣었다. 그래야 한쪽 이야기만 모이지 않는다.
질문마다 사유고의 의미검색으로 관련 쪽 20개를 찾고, 1차 키워드 발췌를 합쳤다. 하위주제마다 150쪽씩 모았는데, 한 권이 독차지하지 않도록 자료당 최대 5쪽으로 막았다. 소득 보고서 재료는 그렇게 59개 자료에서 150쪽이 모였다. 이렇게 하면 “양극화”라는 단어를 한 번도 쓰지 않은 쪽도 들어온다.
노트를 먼저 쓰고, 보고서는 노트로만 쓴다
모델에게 150쪽을 한꺼번에 주고 보고서를 쓰라고 하지 않았다. 두 단계로 나눴다.
- 노트. 서브에이전트 21개가 쪽마다 노트를 달았다. 항목은 어느 섹션에 쓸 내용인지, 주장, 수치, 서술자의 입장, 근거 문장이다. 저자 자신의 주장인지 저자가 인용한 남의 주장인지 가려 적게 했다. 근거 문장은 원문 그대로 복사해야 하고, 검사 스크립트가 원문과 대조한다. 노트 1,050개 중 900개가 관련 있다고 나왔다.
- 보고서. 서브에이전트 7개가 하위주제마다 보고서를 한 편씩 썼다. 근거로 쓸 수 있는 건 노트뿐이다. 모든 문단에 근거 쪽 번호를 하나 이상 달아야 하고, 입력된 쪽의 60% 이상을 한 번은 인용해야 한다. 저자마다 수치가 다르면 합치지 말고 나란히 쓰게 했다.
보고서에 쓰인 숫자 2,268개를 인용 원문과 기계로 대조했다. 불일치는 14개(0.6%)였고, 대부분 책 제목 안의 숫자였다.
한 번은 크게 실패했다. 보고서 작성 에이전트 7개를 동시에 돌렸더니 6개가 끝을 못 냈다. 보고서 하나가 섹션 11개, 문단 45개라 한 번에 쓰기엔 길었다. 세 개씩 나눠 다시 돌리고, 섹션을 하나 쓸 때마다 저장하게 해서 끝냈다.
소득 보고서에서 본 것
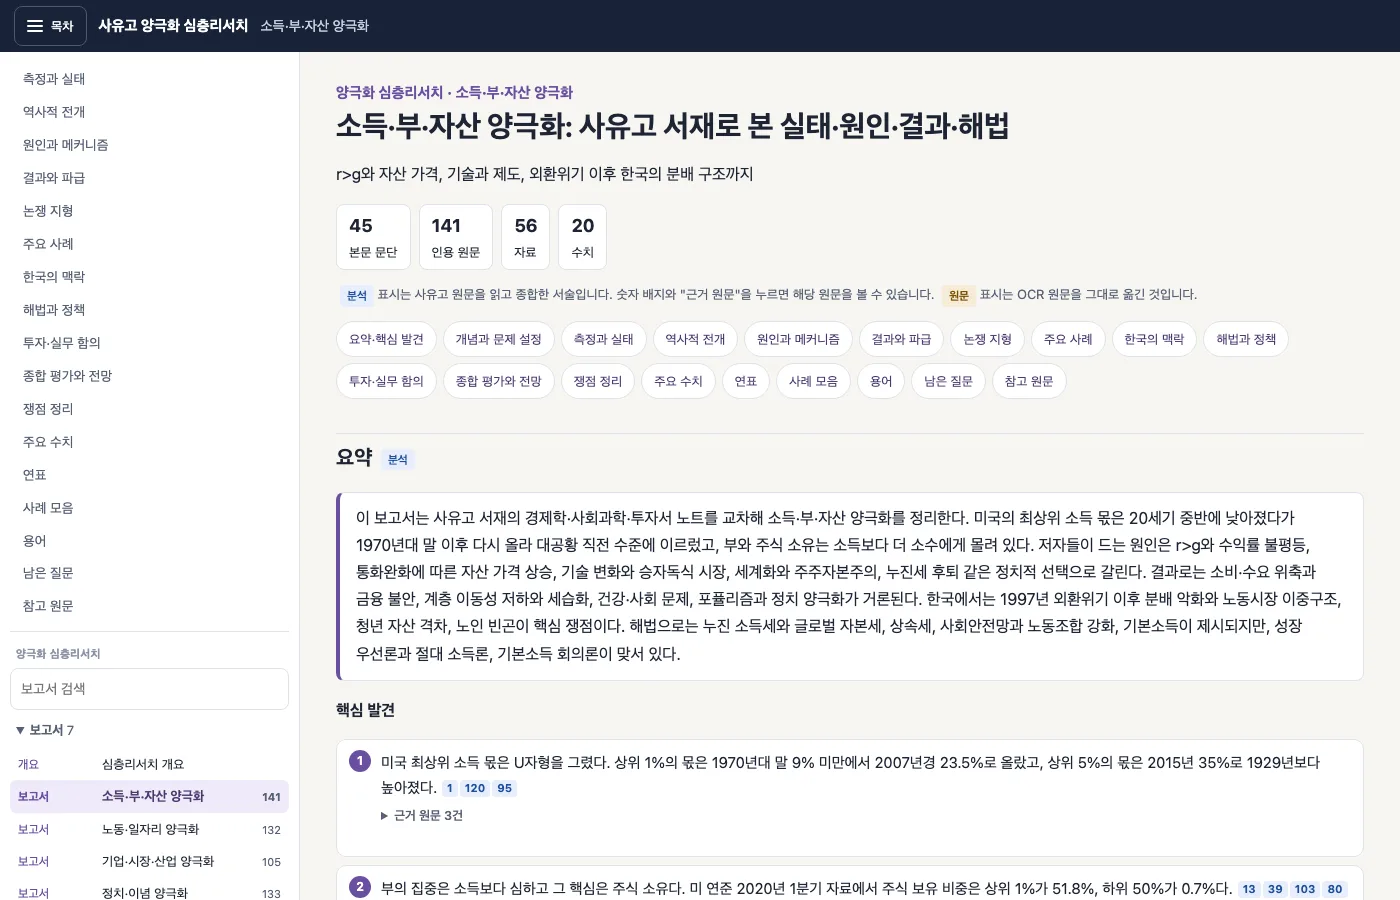
소득·부·자산 보고서는 문단 45개, 인용 원문 141개, 자료 56개다. 주요 수치 20개, 연표 15개, 사례 11개, 용어 15개가 따로 정리돼 있다.
제일 쓸모 있는 건 쟁점 칸이었다. 내 서재 안에서 저자들이 정면으로 부딪히는 지점이 여섯 개 나왔다.
- 불평등은 성장의 대가인가, 성장을 해치는가
- 상대적 격차와 절대 생활수준 중 무엇이 중요한가
- r>g가 부 집중의 핵심 동력인가. 피케티의 주장에 맞서 《애프터 피케티》에 실린 모형 실험은 효과가 작다고 본다.
- 불평등은 사람을 병들게 하는가. 윌킨슨·피킷의 주장에 디턴이 반론을 편다.
- 기본소득은 해법인가
- 불평등 확대는 피할 수 없는 경제의 힘인가, 정치적 선택인가
한 권씩 읽을 때는 각 책이 자기 주장만 한다. 쉰 권 넘는 자료를 가로로 놓으니 누가 누구와 싸우는지가 보인다.
보고서 끝의 “남은 질문” 칸도 좋았다. 보고서가 서재의 빈칸을 스스로 적는다. 한국의 자산 분포를 직접 보여 주는 수치가 서재에 거의 없다. 한국 분배 지표는 2016년 무렵에서 끊긴다. 통화완화가 격차를 키운다는 주장은 투자서에 되풀이되는데 계량 근거는 몇 개 안 된다. 기본소득 실험은 시작했다는 이야기만 있고 결과 평가가 없다. 다음에 어떤 책을 사야 할지가 여기서 나온다.
결과물과 공개 범위
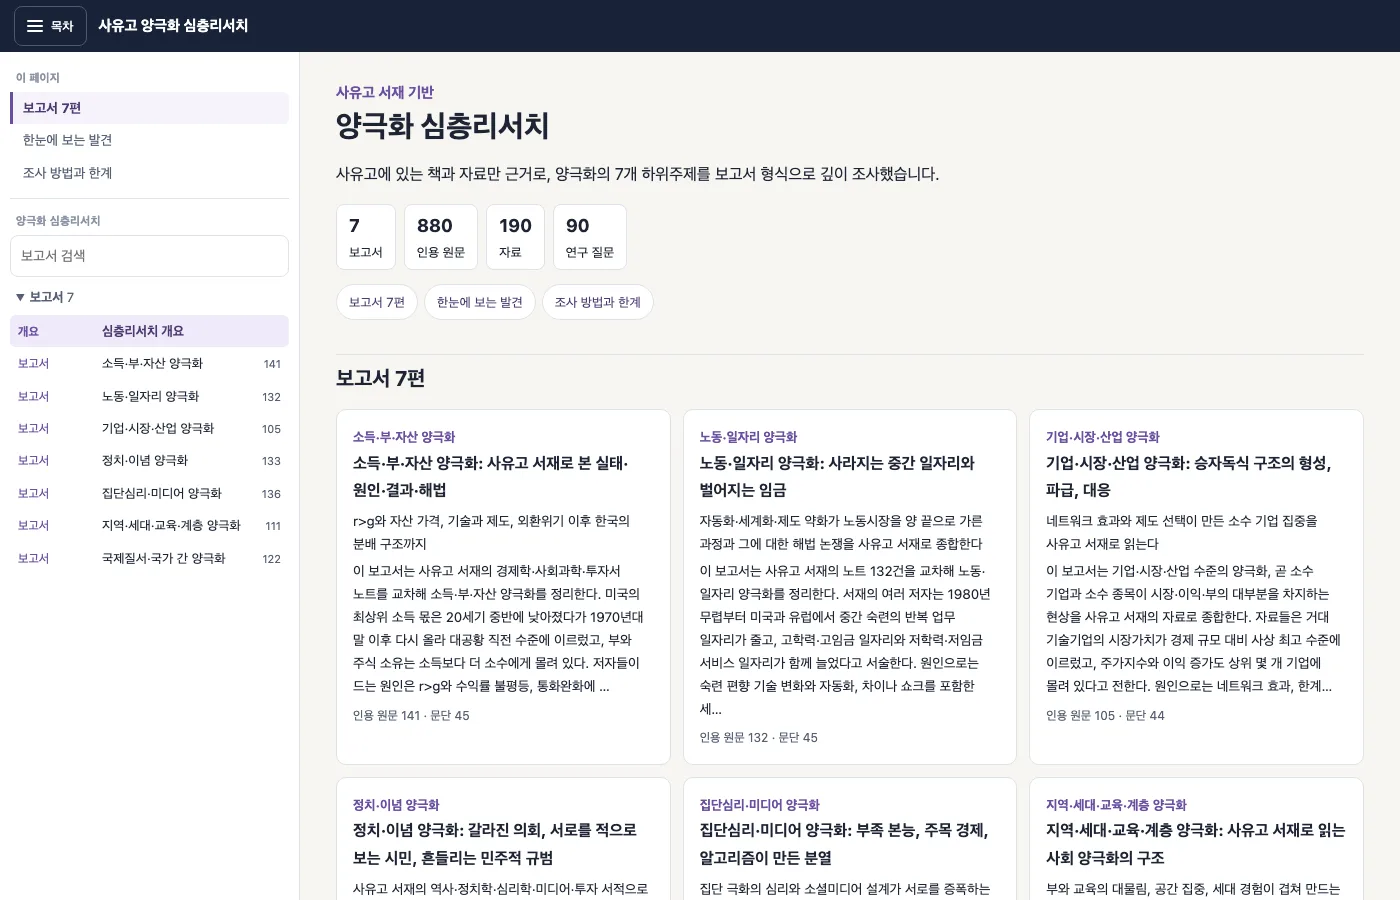
HTML 한 벌이다. 개요 페이지에 보고서 일곱 편이 있고, 보고서마다 요약, 핵심 발견, 섹션 11개, 쟁점, 수치, 연표, 사례, 용어, 남은 질문이 이어진다. 문단 끝의 숫자 배지를 누르면 참고 원문으로 가고, 문단 아래 “근거 원문”을 펼치면 그 문단이 기댄 책 원문이 나온다. 이 부분은 스크립트 없이도 펼쳐진다.
금융위기 때와 마찬가지로 이 HTML은 공개하지 않는다. 문단마다 책 원문이 붙어 있어서다. 이 글에는 AI가 쓴 요약과 구조만 옮겼고, 책 문장은 한 줄도 인용하지 않았다.
한계
- 보고서는 모델이 노트를 종합해 쓴 것이다. 숫자는 기계로 대조했지만, 문단의 논지가 맞는지 사람이 원문과 대조해 검수하지는 않았다.
- 재료는 질문마다 의미검색 상위 20개와 키워드 발췌까지다. 서재의 관련 서술을 전부 모은 것은 아니다.
- 서재가 말하는 것만 적는다. 서재에 없는 최근 통계는 보고서에도 없다. 대신 없다고 적는다.
배운 것
금융위기 때는 정규식으로 전수 스캔하는 방식이 맞았다. 사건 이름이 뚜렷하기 때문이다. 양극화처럼 경계가 흐릿한 주제는 단어가 아니라 질문으로 찾아야 했다. 질문 목록이 곧 보고서 목차가 되고, 반론을 묻는 질문을 넣어야 쟁점이 생긴다.
두 번째로, 모델에게 긴 글을 한 번에 쓰게 하면 실패한다. 쪽마다 노트를 쓰고, 노트로만 보고서를 쓰고, 문단마다 근거 번호를 달게 하니 틀린 곳을 찾아갈 길이 생겼다. 위키룸이 처음부터 지키려던 원칙, 답에서 원문으로 바로 돌아갈 수 있어야 한다는 원칙을 보고서 규모로 옮긴 셈이다.