위키룸 개발로그 · 5화
예측 사건 자동 연결 12,490건, 감사하니 절반도 맞지 않았다
검색 앱이 조사 생산라인이 됐다. 자동으로 연결한 예측 사건 12,490건은 감사해 보니 절반도 맞지 않았다. 카카오톡은 증분 동기화로, 유튜브 자막은 네 가지 신뢰성 게이트로 다시 다졌다.
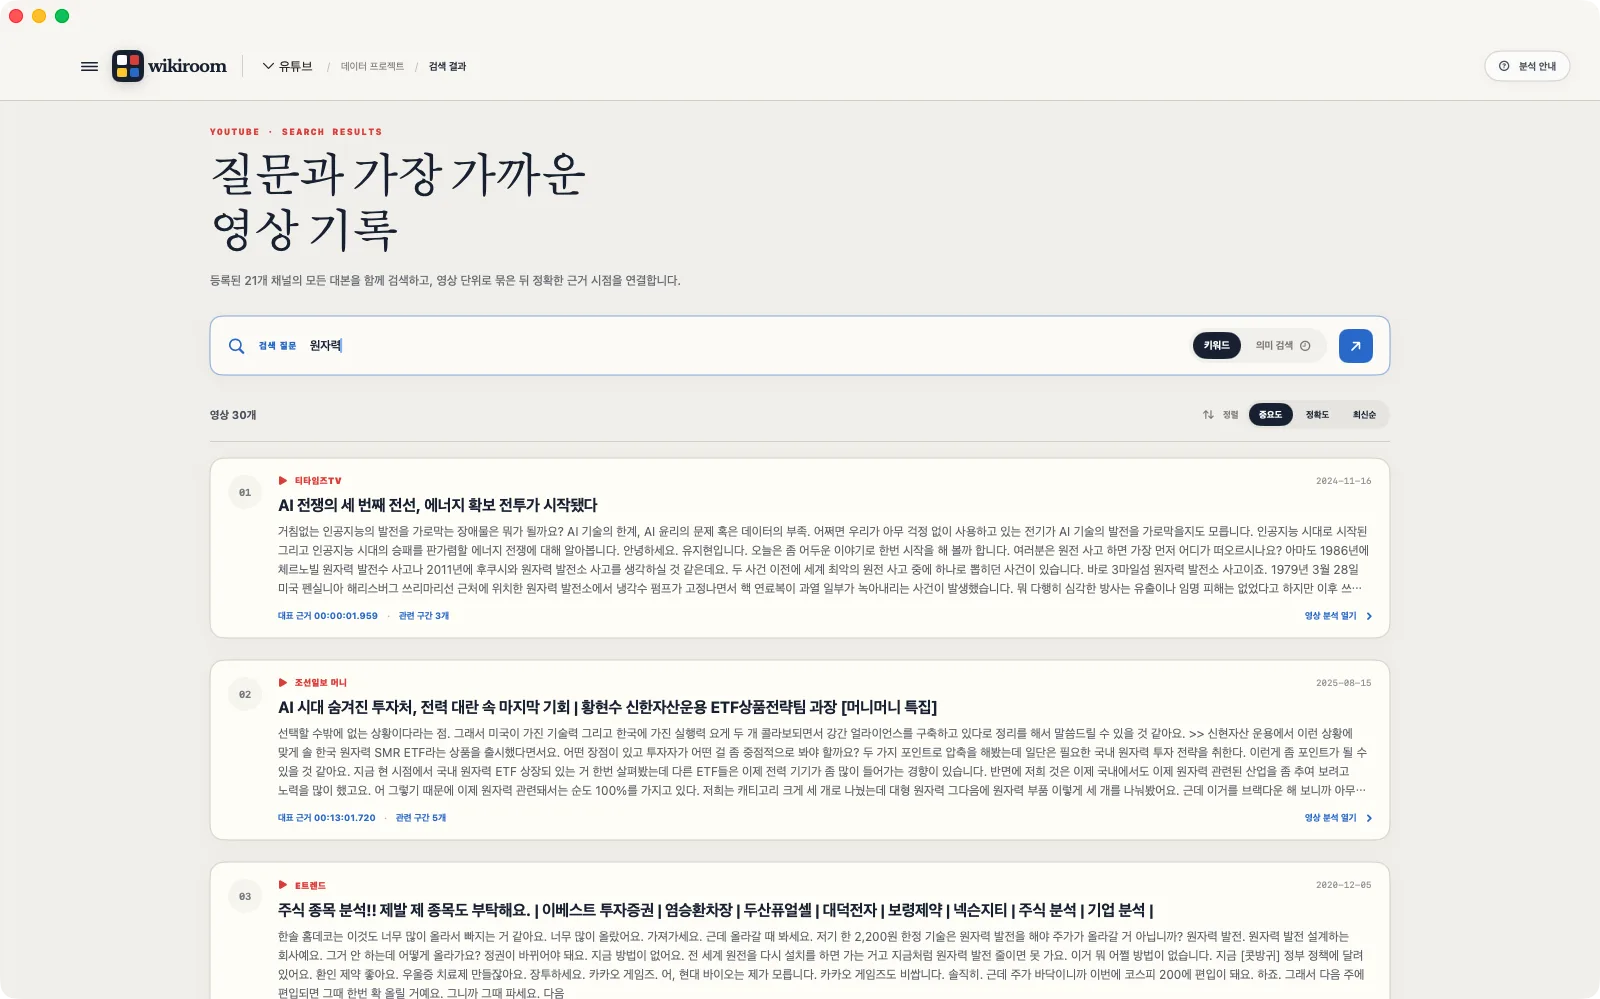
8월 중순부터 위키룸은 검색 앱보다 조사 생산라인에 가까워졌다. 카카오톡 속 공개 도구 카탈로그, 투자 유튜브 17개 채널 전체 검색, 토큰 원가 보고서처럼 서로 다른 결과물이 같은 검색·근거 계층 위에서 나왔다. 카카오톡 전체 검색 결과는 독립 HTML 카탈로그로, 유튜브 전체 검색은 채널과 영상과 타임코드를 보존한 조사 원장으로 남겼다.
12,490건과 48.1%
8월 16일에는 규모가 큰 조사를 돌렸다. 투자 유튜브에 나온 전문가들의 예측을 뽑아 실제 가격 움직임과 대조하는 보고서였다. 자동으로 연결한 예측 사건이 12,490건이었고, 사건마다 가격 차트가 붙었다.
숫자는 인상적이었지만 나는 개인별로 실제로 어떤 예측을 했고 가격이 어떻게 움직였는지를 직접 보고 싶었다. 표본을 뽑아 감사해 보니, 자동으로 연결한 사건이 의미까지 맞는 비율은 48.1%였다. 자동 자막이 단어를 잘못 알아들은 경우, 어떤 종목을 그냥 언급한 걸 예측으로 읽은 경우가 섞여 있었다. 규모가 개별 사건의 의미 검증을 대신해 주지 않았다.
보고서를 고쳤다. 인물별 전체 사례, 자동 자막 원문, 그 시점으로 가는 영상 링크, 실제 종가 경로를 함께 보여 주고, 사람이 검수하지 않은 사건에는 미검수 표시를 붙였다. 감사 정밀도 48.1%라는 한계도 보고서 안에 그대로 적었다. 대량 추출과 최종 판단을 분리한 것이다.
카카오톡 증분 동기화
8월 30일에는 카카오톡 쪽을 다졌다. 그동안 동기화는 매번 원문을 처음부터 다시 읽었다. 메시지가 늘수록 느려졌다.
카카오톡 DB의 메시지마다 붙는 번호(logId) 중 아카이브에 이미 있는 가장 큰 값을 기준선으로 잡고, 그 뒤만 읽게 했다. 날짜가 아니라 번호를 쓴 이유는 실제로 빠진 메시지 후보들이 모두 기준 번호보다 컸기 때문이다. 경계에서 한 건을 겹쳐 읽고 기존 키로 중복 없이 넣는다. 메시지 저장과 동기화 위치 갱신은 한 트랜잭션으로 묶어서 실패하면 전부 되돌린다. 다른 카카오톡 계정의 아카이브와는 섞이지 않게 막았다.
원문 읽기만 증분으로 하고, 검색 구간과 키워드 색인은 매번 현재 아카이브 전체에서 다시 만든다. 메시지는 저장됐는데 구간을 만들다 중간에 끊긴 경우에도 다음 동기화가 반드시 복구하게 하려는 것이다. 동기화가 마지막 의미 색인보다 늦으면 진단 명령이 “의미 검색 전에 색인 필요”를 알린다.
실제 동기화 전에 아카이브와 벡터 DB를 백업하고 무결성 검사를 통과시킨 뒤 돌렸다. 첫 동기화에서 26만 3,840건이 들어왔고, 곧바로 다시 돌리자 그사이 도착한 3건만 들어왔다. 첫 의미 색인을 도는 동안 75건이 더 왔고, 마지막으로 한 번 더 따라잡았다. 새 대화 구간 17,902개를 로컬 임베딩으로 색인해 벡터가 71,905개가 됐다.
유튜브 자막 네 가지 게이트
다음 날은 유튜브 쪽이었다. 채널 전체 자막을 근거로 쓰면 네 가지 문제가 생긴다. 자동 자막의 잡음, 누가 한 말인지 모르는 문제, 검색 성능을 잰 적이 없는 문제, 모델이 만든 주장과 원문이 섞이는 문제. 각각을 실행 가능한 검사로 만들었다.
- 자막 품질: 구간마다 품질 점수와 등급을 붙인다. 음성과 대조한 정확도가 아니라 짧은 정보량, 상투적인 끝인사, 반복, 기호 잡음처럼 눈에 보이는 이상 징후 점수다. 정확도를 잰 척하지 않기 위해 이름부터 그렇게 제한했다.
- 화자: 원본에 화자 표시가 있으면 쓰고, 없으면 문장 첫머리의 진행자·게스트 같은 표지만 보수적으로 읽는다. 제목이나 채널 이름만으로 특정 인물의 말이라고 추정하지 않는다. 기존 DB에는 그런 표시가 없어서 구간 432만 개 전부가 “모름”으로 남았다. 잘못 귀속하는 것보다 안전한 실패다.
- 검색 평가: 정답 구간과 프로젝트·영상·구간·시작 시각·클립 링크가 모두 일치해야 맞힌 것으로 치는 평가기를 만들었다. 같은 영상이 여러 채널 DB에 겹칠 때 출처가 섞이는 걸 잡으려는 것이다.
- 주장 검증: 분석이 낸 주장을 DB를 다시 열어 확인한다. 인용이 정확한지, 숫자가 맞는지, 부정문을 긍정으로 뒤집지 않았는지, 확실성을 부풀리지 않았는지. 검증기에는 원문 텍스트를 따로 넘기지 않는다. 분석기가 가공한 텍스트를 스스로의 근거로 내미는 순환을 막으려는 것이다.
금융 채널 17개 프로젝트의 영상 152,628편, 구간 4,319,444개 전체에 품질 점수를 새로 매겼다. 원문 자막과 키워드 색인과 벡터는 건드리지 않고 새 열만 채웠다. 등급별 합계가 전체 구간 수와 정확히 맞는 걸 확인하고 끝냈다.