사유고 개발로그 · 9화
사유고2는 책 795권을 원문 10분의 1 크기 지도로 바꿨다: 답하는 서재에서 늘어놓는 서재로
사유고는 책에 물으면 근거를 붙여 풀어서 답하는 서재다. 책이 수백 권 쌓이자 여러 책을 한 번에 늘어놓을 구조가 필요해 사유고2를 만들었다. 집의 DGX Spark 두 대가 로컬 모델로 80.5시간 동안 795권을 원문 10분의 1 크기 지도로 바꿨고, 맥 앱에서 한 단어로 모든 책의 주장·근거·화자를 가로질러 찾는다.
사유고는 찍어 둔 종이책에 물으면 근거 문장과 원본 페이지를 붙여 풀어서 답하는 서재다. 7월에 시작해 검색, 저자 토론, 학습 루프, 완독 코스까지 붙였다. 이 연재 1~8화가 그 이야기다. 9화부터는 그 옆에 새로 세운 사유고2 이야기다.
사유고1은 묻는 말에 답했고, 책이 쌓이자 늘어놓을 구조가 필요해졌다
사유고1은 질문 하나에 답 하나를 준다. 책을 이해시키는 서술형이다. 그런데 서재가 수백 권이 되자 다른 것이 아쉬워졌다. 여러 책이 같은 주제를 어떻게 다르게 말하는지 한 번에 늘어놓고 싶었다. 질문할 때마다 찾아 모으는 게 아니라, 책들이 미리 정렬된 구조로 놓여 있어 데이터로도 쓸 수 있으면 했다.
그렇다고 키워드만 뽑으면 뜻이 사라진다. 원하는 건 세 가지였다. 사람이 읽어도 바로 이해될 것, 원문보다 훨씬 작을 것, 뜻이 그대로 살아 있을 것. 책 한 권을 그런 구조로 바꾸는 일을 집의 DGX Spark에 맡기기로 했다.
책 한 권을 원문 10분의 1 크기 지도로 바꿨다: 14단계 230만 토큰에서 경량 지도 3.2만 토큰으로
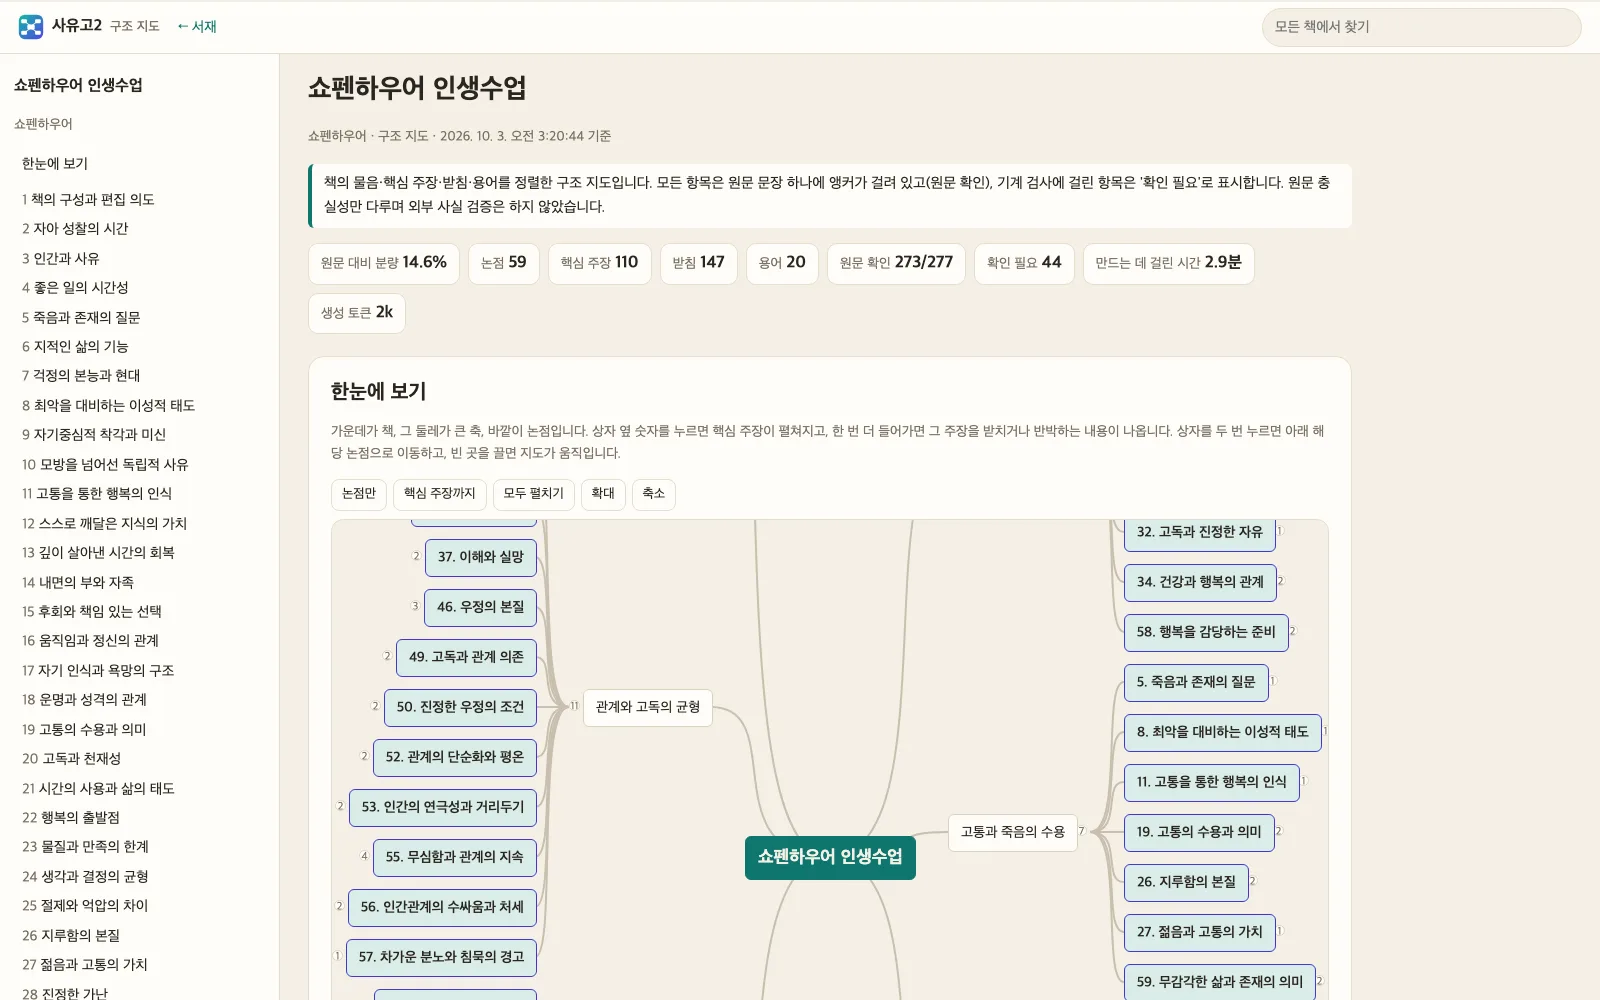
지도에는 책의 중심 물음과 답, 큰 축 세 개에서 여섯 개, 논점, 논점마다 핵심 주장과 그 주장을 받치는 근거·사례·조건·반론, 용어, 그리고 저자가 아닌 사람의 말이 들어간다. 항목 하나에는 명제 하나만 담고, 항목마다 원문 문장 하나에 걸어 둔다.
처음에는 한 권을 14단계로 꼼꼼히 쪼갰다. 대표 책 한 권에 230만 토큰을 생성할 판이었고, 네다섯 시간이 걸렸다. 704권이면 몇 달이다. 그래서 구간마다 모델을 한 번 부르고 검사에 걸린 항목만 고치는 경량 지도로 바꿨다. 같은 책이 4.7분, 생성 3.2만 토큰으로 끝났고, 지도 분량은 원문의 9~12%였다.
모델이 쓴 문장은 그대로 믿지 않는다. 앱이 항목의 앵커가 원문과 글자 그대로 맞는지 대조하고, 따옴표 안의 말을 저자 말로 적었는지, 옮긴이 주를 저자 정의로 옮겼는지, 원문에 없는 원어나 숫자를 덧붙였는지 기계로 한 번 더 본다. 통과하면 “원문 확인”, 고쳐 써도 걸리면 “확인 필요”가 붙는다. 이 검사들은 첫 시험 책을 원문과 대조하다 실제로 나온 잘못에서 만들었다.
스파크 두 대가 80.5시간 만에 795권을 실패 없이 끝냈다
10월 2일 23시 51분에 서재 전체를 돌리기 시작했다. 2번 스파크는 이 일만 하고, 1번은 영상이나 딥리서치가 비어 있을 때만 빌려 썼다. 짧은 책부터 처리하고, 도중에 새 책이 들어오면 10분 안에 대기열의 크기 순서 자리에 끼워 넣었다. 그사이 대상은 704권에서 795권으로 늘었다.
10월 6일 8시 22분에 끝났다. 795권 모두 지도가 생겼고 실패는 0권이었다. 마지막 책은 논점 360개짜리 『러셀 서양철학사』였다. 70시간 시점까지 모델이 처리한 토큰은 약 3억 5,800만 개다. 이 과정은 스파크 활용 연재에 따로 적었다.
사유고1의 완독 코스는 Claude 구독으로 만들었다. 그래서 8화처럼 사용 한도를 지키는 문지기가 필요했다. 사유고2는 집 장비의 로컬 모델이 만든다. 한도를 셀 필요가 없고, 대신 장비를 영상·리서치와 나눠 쓰는 순서를 정해야 했다.
맥 앱에서는 한 단어로 모든 책의 주장·근거·화자를 가로지른다
맥 앱 사유고2는 10분마다 스파크에서 새 지도를 받아 검색 색인을 다시 만든다. 서재에는 책마다 중심 물음 한 줄과 논점·주장 수, 원문 대비 분량이 붙는다.
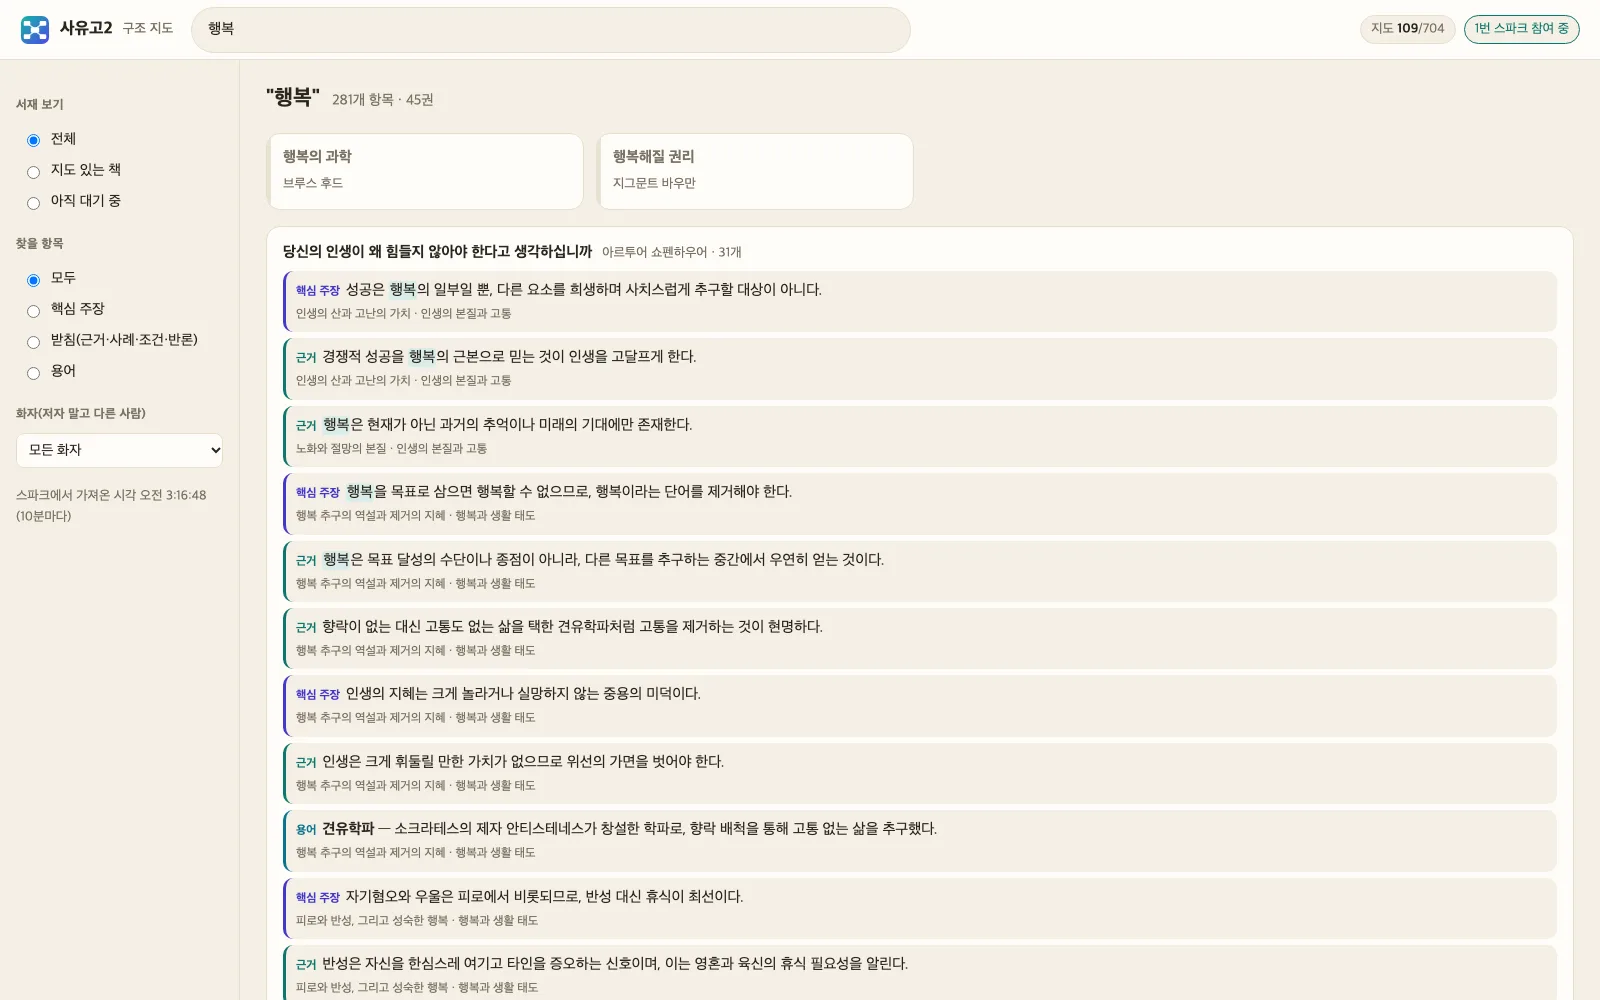
검색창에 한 단어를 넣으면 모든 책에서 그 말이 들어간 주장, 근거, 사례, 용어가 책별로 묶여 나온다. 화자를 고르면 한 인물이 여러 책에서 어떻게 인용되고 반박됐는지 한 화면에 모인다. 책을 열면 지도의 숫자, 마인드맵, 책의 큰 그림, 논점별 논증 지도 순서로 내려간다. 10월 5일에는 근거 옆에 원문 페이지 사진을 띄우는 기능도 붙였다.
사유고1은 풀어서 답하고, 사유고2는 구조로 늘어놓는다
| 사유고1 | 사유고2 | |
|---|---|---|
| 하는 일 | 질문에 근거를 붙여 풀어서 답한다 | 책을 구조 지도로 바꿔 늘어놓는다 |
| 기본 단위 | 쪽과 문단 | 중심 물음, 큰 축, 논점, 주장, 근거, 용어, 화자 |
| 여러 책 | 질문할 때마다 찾아 모은다 | 한 단어로 모든 책을 미리 정렬된 항목으로 가로지른다 |
| 확인 방법 | 근거 문장과 원본 페이지를 붙인다 | 항목마다 원문 문장 앵커를 글자 그대로 대조하고 기계 검사를 거친다 |
| 만드는 곳 | 맥과 클라우드 모델(완독 코스는 Claude 구독) | 집의 DGX Spark 두 대와 로컬 모델 Qwen3.8 Flash Next |
| 결과물 | 답, 강의, 마인드맵 | 원문 10분의 1 크기 지도. 다른 프로그램이 데이터로 쓸 수 있다 |
사유고1이 책 한 권을 깊게 이해시키는 쪽이라면, 사유고2는 서재 전체를 한 번에 펼쳐 놓는 쪽이다. 둘 중 하나가 다른 하나를 대신하지 않는다.
두 서재는 서로의 데이터를 고치지 않는다: 원본만 보내고 결과는 보기용으로 받는다
사유고1은 그대로 두었다. 스파크로 가는 것은 책의 원문 텍스트와 서지와 정식 표지뿐이다. 페이지 사진이나 사유고1이 만든 강의, 인용, 진도는 보내지 않는다. 원본은 해시로 확인해 한 방향으로만 보내고, 같은 원본을 여러 번 보내도 결과가 같다. 스파크에서 만든 지도는 맥 앱이 보기용으로만 받는다. 앱 아이콘도 사유고1의 남색·금색 대신 청록·남보라로 구분해 Dock에서 바로 옆에 두었다.
배운 것: 꼼꼼한 14단계보다 한 번 부르고 걸린 것만 고치는 쪽이 서재 전체를 끝냈다
14단계 방식은 한 권을 더 꼼꼼히 다뤘을지 모른다. 하지만 그 속도로는 서재 전체에 닿지 못했다. 한 번에 만들고, 기계 검사로 걸린 항목만 고치고, 그래도 걸리면 표시해 두는 방식이 795권을 80.5시간에 끝냈다.
지도가 서재 전체에 생기자 다음 질문이 생겼다. 책마다 따로 있는 주장과 인물과 개념을 서로 이으면 무엇이 보일까. 그 이야기가 다음 화의 지식 연결망이다.
사유고 개발로그 · 전 11화
- 1화종이책 사진에 물어보는 서재: 글자·그림 검색 두 갈래로 세웠다
- 2화저자 토론 기능을 붙였다: GPT가 저자 연기를 거부했다
- 3화학습 루프를 만들었다: 증거 없이 완료되는 구멍이 나왔다
- 4화저자 인터뷰와 대목 연결 기능을 붙였다: 결함 5개를 먼저 고쳤다
- 5화책 587권 자동 등록: 파일은 왔는데 페이지가 빠져 있었다
- 6화AI 강의 품질을 쟀다: 모델이 쓴 인용은 문구가 바뀌고 쪽수가 틀렸다
- 7화600권 완독 코스·마인드맵을 배치로 미리 만들기 시작했다
- 8화배치 사용량 문지기: 5시간 한도 80%에서 쉬고 주간 90%에서 멈춘다
- 9화사유고2는 책 795권을 원문 10분의 1 크기 지도로 바꿨다: 답하는 서재에서 늘어놓는 서재로
- 10화투자 책 50권만으로 노트 2,094개짜리 지식 연결망이 나왔다: 795권으로 키우기 전에 고민할 것
- 11화사유고 촬영 자동화를 맥북 프로에서 맥북 에어로 옮겨 같은 작업을 이어 갔다: 바꾼 코드는 두 줄이었다