사유고 개발로그 · 10화
투자 책 50권만으로 노트 2,094개짜리 지식 연결망이 나왔다: 795권으로 키우기 전에 고민할 것
사유고2 구조 지도에서 개념·인물·사건을 허브로 뽑고 책 사이 주장 관계를 이어 옵시디언 볼트를 만들었다. 투자 책 50권 시험판에서 허브 2,037개, 책 사이 관계 2,746쌍이 나왔다. 50권으로 이 정도면 795권은 어떻게 보여야 할지, 반박 판정은 믿을 만한지부터 고민해야 한다.
9화에서 사유고2가 795권 모두를 구조 지도로 바꿨다. 지도는 책 한 권 안의 주장과 근거를 정리한다. 그럼 책과 책 사이는 어떨까. 여러 책에 같은 개념, 같은 인물, 같은 사건이 나온다. 어떤 책은 다른 책의 주장을 받치고, 어떤 책은 반박한다. 이걸 이으면 서재가 하나의 신경망처럼 보일 것 같았다. 지도가 다 끝난 10월 6일 아침에 바로 시작했다.
사유고2 지도에서 허브와 책 사이 관계를 뽑아 새 옵시디언 볼트로 만들었다
구조는 이렇게 잡았다. 여러 책에 걸쳐 나오는 개념·인물·사건·시대·장소·기관을 허브로 만든다. 책 노트는 자기 책에 나오는 허브에 연결된다. 그리고 두 책의 주장 쌍마다 지지하는지, 같은 말인지, 구체화하는지, 반박하는지를 판정해 붙인다. 읽고 판정하는 일은 스파크의 로컬 모델이 맡고, 볼트는 그 결과를 담은 데이터베이스에서 통째로 다시 만든다. 예전에 손으로 쌓던 옵시디언 볼트는 건드리지 않고 “사유고2 연결망”이라는 새 볼트를 열었다.
시험판은 투자 책 50권으로 했다: 지도 글자 113만 자, 주장 1만 800개
바로 795권을 돌리지 않았다. 사유고1에서 투자로 분류된 146권 가운데, 다른 투자 책과 이름이 많이 겹치는 50권을 골랐다. 지도 글자가 5만 자를 넘는 책은 빼고, 내가 앱에서 직접 열어 본 『돈의 심리학』, 『100배 주식』, 『1%를 읽는 힘』은 넣었다. 지도 글자로 113만 자, 주장 1만 800개, 받침 1만 3,740개, 용어 3,930개다.
먼저 『돈의 심리학』 한 권으로 시험했다. 모델을 8번 불러 2분 만에 주장 124개에 모두 답했고, 인물 73명, 사건 14개, 기관 18곳이 모두 본문에서 확인됐다.
50권 첫 실행은 도중에 멈췄다. 모델의 답이 길이 한도에서 잘렸는데, 작업기가 그걸 서버 고장으로 보고 두 스파크를 모두 쉬게 했다. 길이 잘림은 서버 탓으로 세지 않게 고치고 한도를 올려 다시 돌렸다. 두 스파크가 약 85분 동안 1,237번 불렸고, 252만 토큰을 읽고 188만 토큰을 썼다.
50권에서 허브 2,037개, 노트 2,094개, 책 사이 관계 2,746쌍이 나왔다
10월 6일 11시 31분에 볼트가 나왔다.
| 항목 | 수 |
|---|---|
| 노트 | 2,094개 (허브 2,037, 책 50, 논쟁 7) |
| 이름 원본 → 허브 | 9,500개 → 8,604개 (두 권 이상에 나오는 허브 2,028개) |
| 논쟁에서 갈린 편 | 2,821개 |
| 판정한 주장 쌍 | 5,420쌍 (두 책을 잇는 관계 2,746쌍, 무관 2,174쌍) |
| 두 책을 잇는 관계 | 지지 575, 같은 말 213, 구체화 1,022, 반박 936 |
가장 많이 이어진 허브는 분산투자(42권), 주가수익비율(40권), 워런 버핏(40권), 2008년 금융위기(33권), S&P 500(28권)이었다. 투자 책 50권이 무엇을 공통으로 이야기하는지가 허브 크기로 드러났다.
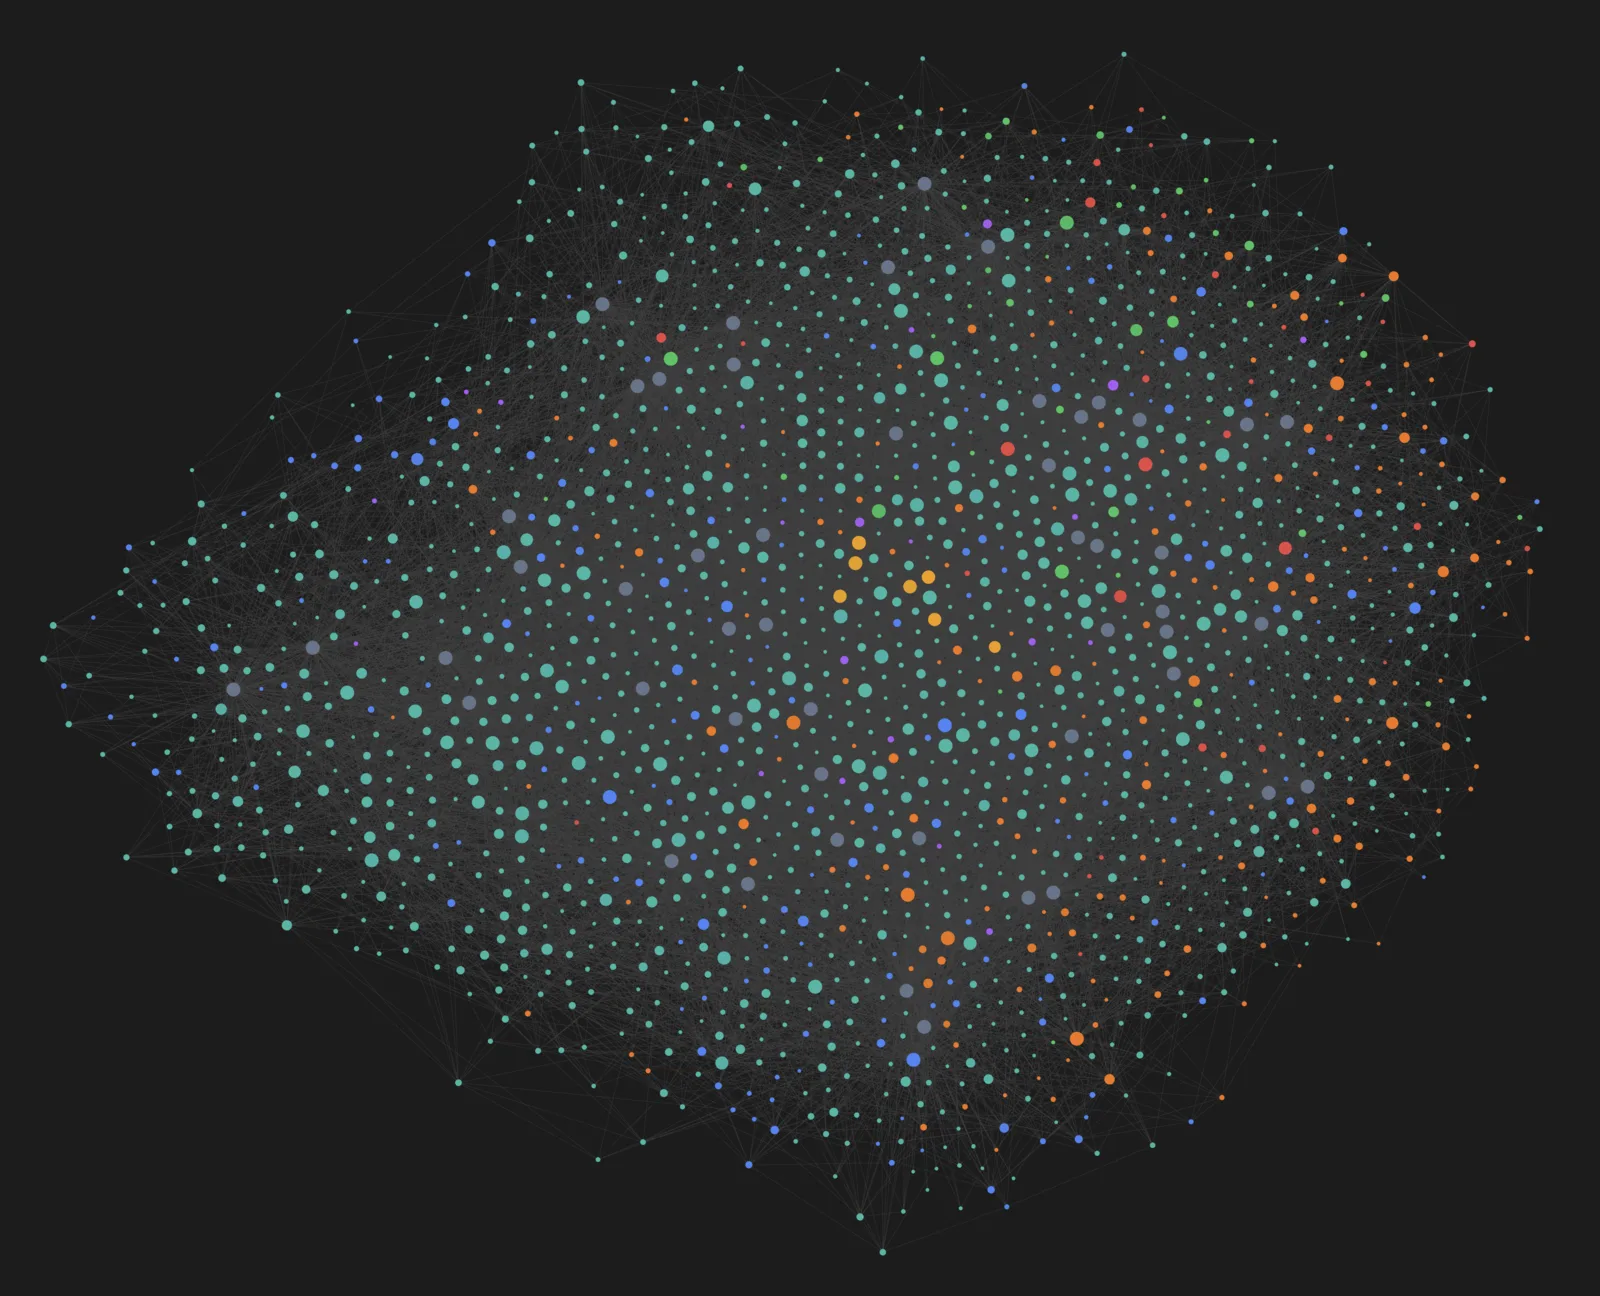
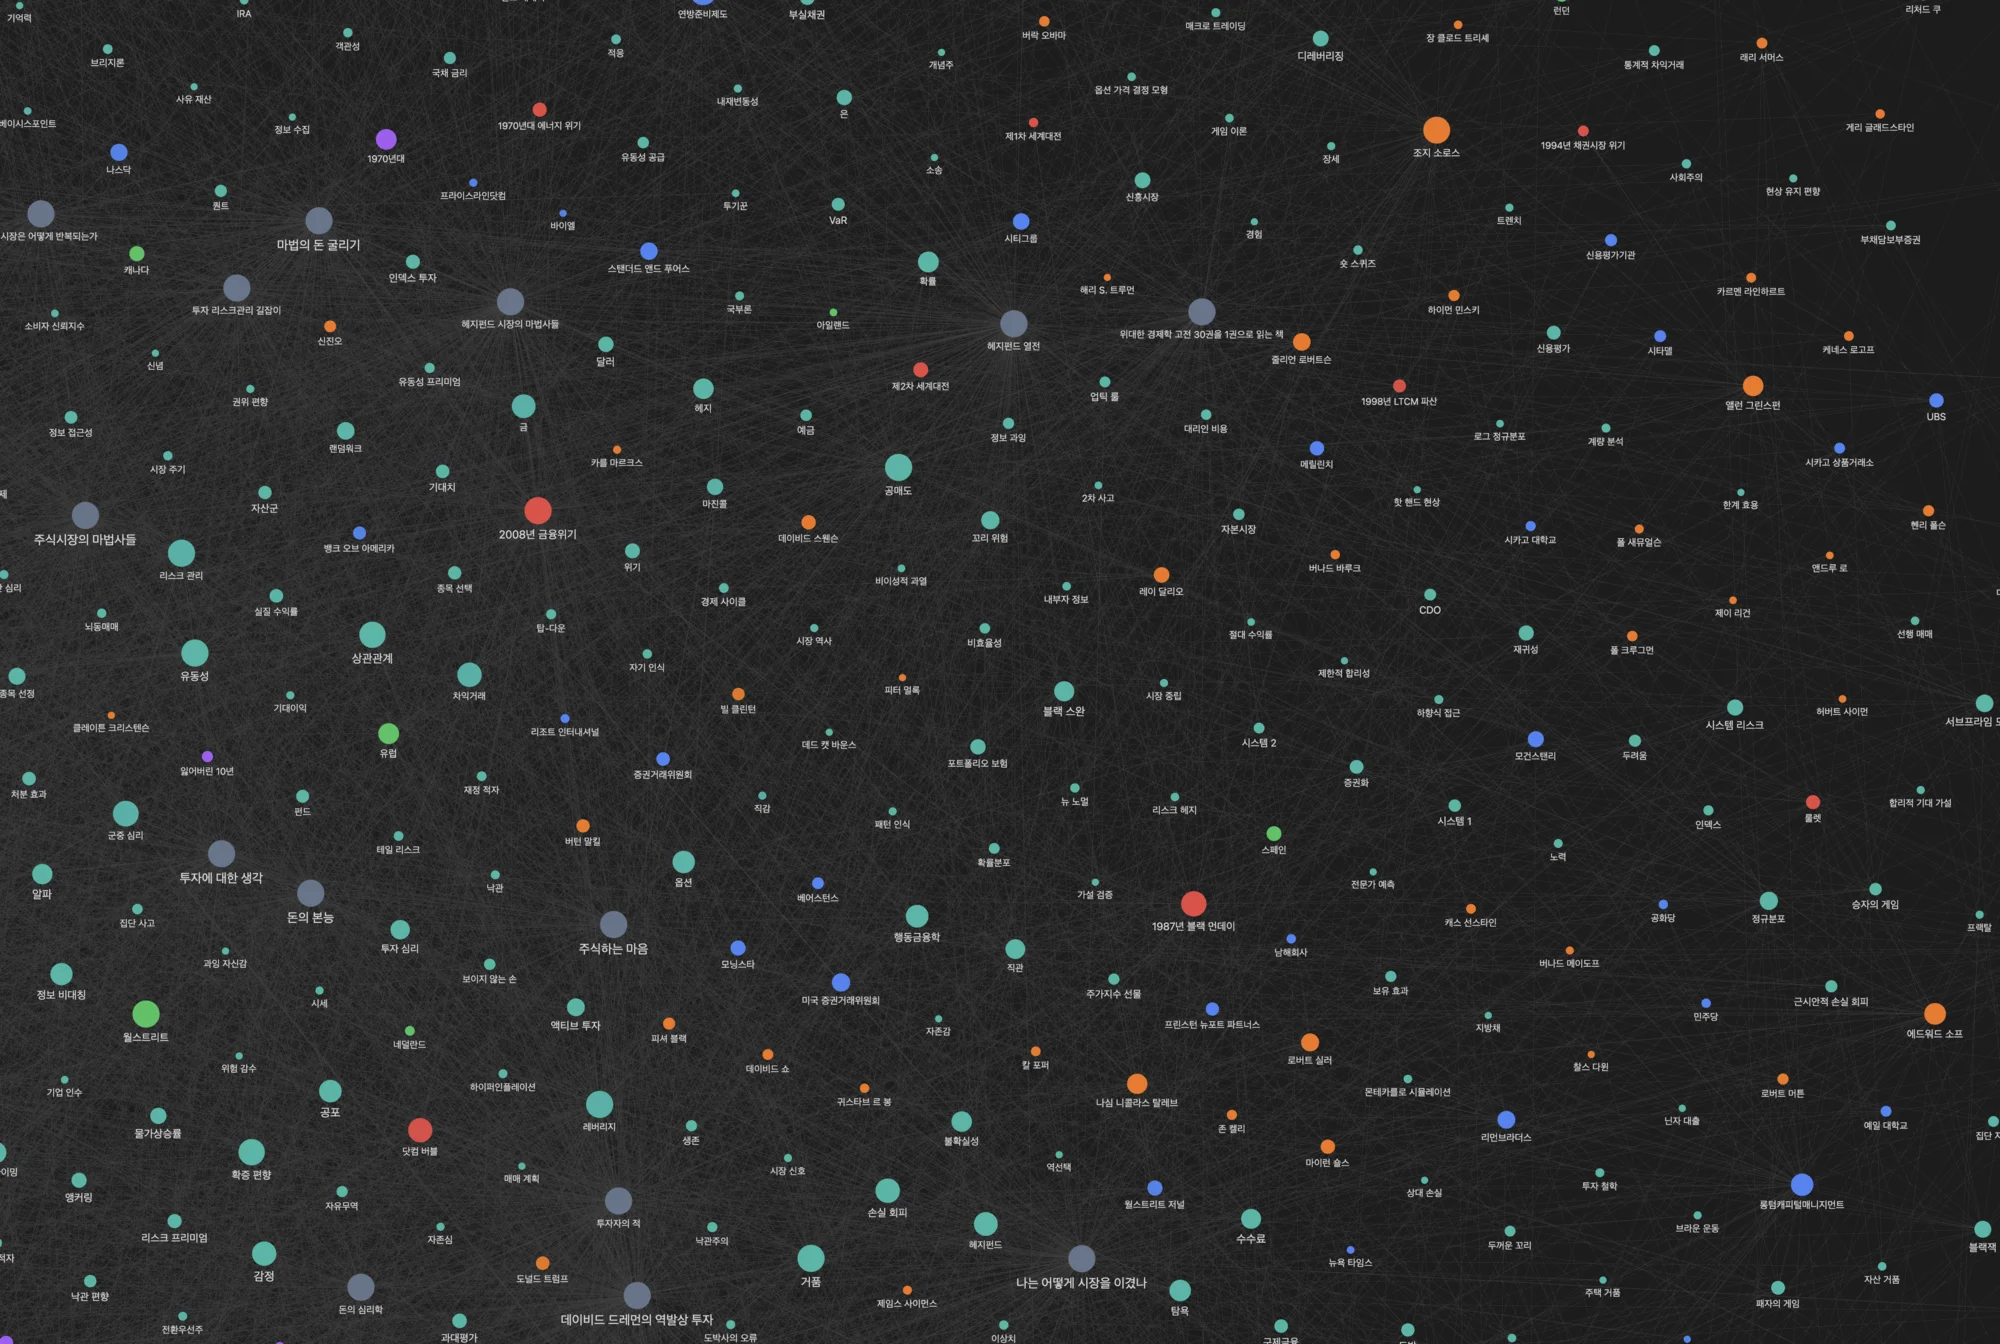
처음 만든 볼트에는 모든 노트를 잇는 홈 노트가 있었다. 그래프에서 보니 그 노트 하나가 가운데에 박혀 모든 선을 끌어모았다. 이상해 보여서 홈 노트를 뺐다.
같은 이름 합치기는 모델에게만 맡기면 지나치게 합쳤다
같은 대상을 가리키는 이름을 하나로 합치는 일을 처음에는 스파크의 판정에 맡겼다. 결과는 지나치게 합쳤다. 넓은 이름과 좁은 이름을 합쳤고, 합친 것이 사슬처럼 이어졌고, 한 글자 차이인 ‘자산’과 ‘자본’도 하나가 됐다.
그래서 합치는 경우를 좁혔다. 자모 하나 차이의 철자, 성과 전체 이름, 사건 앞에 붙은 연도, ‘사태·위기·효과’ 같은 꼬리, 그리고 동의어 후보 중 판정까지 통과한 것만 합친다. 성이 같은 두 사람은 합치지 않고, 허브 하나가 이 방식으로 이름을 다섯 개 넘게 받아들이지 못하게 막았다.
허브와 지지는 맞았고, 반박과 구체화는 다섯 개 중 두 개만 진짜였다
표본을 열어 보며 품질을 봤다. 허브와 용어 정의는 맞았다. 예를 들어 ‘안전마진’ 허브에는 24권이 각자 내린 정의가 나란히 모였다. 책 한 권씩 읽어서는 볼 수 없던 장면이다. 지지 관계도 맞았고, 같은 말도 대부분 맞았다.
문제는 반박과 구체화였다. 반박으로 판정된 것 다섯 개 중 진짜 반박은 두 개 정도였다. 사유고2 지도 쪽 오류도 하나 나왔다. 워런 버핏에 관한 한 책의 지도가 워런의 말로 읽히는 주장 38개를 하워드 버핏에게 돌려 두었다. 반박·구체화 약 1,950쌍은 모델의 생각 기능을 켜고 다시 판정하기 전까지 믿지 않기로 했다.
50권으로 이 정도면 795권은 다른 문제다: 고민해 봐야 할 것들
50권만으로 노트가 2,000개를 넘었다. 이 정도 신경망이 나온다면, 795권으로 키웠을 때 무엇이 보이고 무엇이 묻힐지 고민해 봐야 한다. 바로 키우기 전에 생각할 것이 몇 가지 있다.
- 보는 방법: 허브가 수천 개를 넘으면 옵시디언 전체 그래프는 털실 뭉치가 된다. 허브와 책 노트만 볼트에 두고, 주장 단위 관계는 앱에서 필요할 때 펼쳐 보는 쪽이 맞을지도 모른다.
- 관계의 신뢰도: 지지는 믿을 만하지만 반박은 아직 아니다. 서재가 커질수록 틀린 반박이 그럴듯한 논쟁처럼 보이게 된다. 판정을 다시 돌리는 비용과 사람이 표본을 보는 방법을 먼저 정해야 한다.
- 합치기의 경계: 이름을 덜 합치면 같은 개념이 흩어지고, 더 합치면 다른 개념이 섞인다. 50권에서 정한 규칙이 795권에서도 맞을지는 모른다.
- 순서: 다음은 투자 책 146권, 그다음 795권이다. 그 전에 내가 이 볼트를 직접 읽어 보고 쓸모를 확인하기로 했다.
배운 것: 연결은 쉽게 많아지고, 많아진 연결은 읽기 어렵다
책 사이를 잇는 일 자체는 생각보다 빨랐다. 85분 만에 2,000개가 넘는 노트가 생겼다. 어려운 건 그다음이다. 무엇을 합치고, 어떤 관계를 믿고, 어디까지 보여 줄지는 모델이 정해 주지 않는다. 50권이 보여 준 건 가능성과 함께, 795권 전에 답해야 할 질문들이었다.
사유고 개발로그 · 전 11화
- 1화종이책 사진에 물어보는 서재: 글자·그림 검색 두 갈래로 세웠다
- 2화저자 토론 기능을 붙였다: GPT가 저자 연기를 거부했다
- 3화학습 루프를 만들었다: 증거 없이 완료되는 구멍이 나왔다
- 4화저자 인터뷰와 대목 연결 기능을 붙였다: 결함 5개를 먼저 고쳤다
- 5화책 587권 자동 등록: 파일은 왔는데 페이지가 빠져 있었다
- 6화AI 강의 품질을 쟀다: 모델이 쓴 인용은 문구가 바뀌고 쪽수가 틀렸다
- 7화600권 완독 코스·마인드맵을 배치로 미리 만들기 시작했다
- 8화배치 사용량 문지기: 5시간 한도 80%에서 쉬고 주간 90%에서 멈춘다
- 9화사유고2는 책 795권을 원문 10분의 1 크기 지도로 바꿨다: 답하는 서재에서 늘어놓는 서재로
- 10화투자 책 50권만으로 노트 2,094개짜리 지식 연결망이 나왔다: 795권으로 키우기 전에 고민할 것
- 11화사유고 촬영 자동화를 맥북 프로에서 맥북 에어로 옮겨 같은 작업을 이어 갔다: 바꾼 코드는 두 줄이었다