로컬 영상 뽑기 · 4화
H3가 2.8배 빨라졌다: PyTorch 2.13과 ck attention 설정 두 줄
PyTorch를 2.13으로 올리고 ck attention을 켜자 5090의 H3가 2.8배 빨라졌다. 두 장비의 비교우위가 바뀌었고, 10분 영상 한 편의 장면을 84분에 다 만들었다.
지난 화에서 기존 제작 로그로 두 장비의 속도를 정리했다. 5090의 H3는 영상 1초를 만드는 데 57초가 걸렸다. 터보 8스텝을 쓰고 두 장비에 나눠 돌려도, 10초짜리 H3 클립 하나에 10분 가까이 드는 셈이었다. 이번에는 모델이나 스텝이 아니라 그 아래, 실행 환경을 바꿔 봤다.
바꾼 것 셋: PyTorch 2.13, ck attention, LTX 메모리 상주
이어서 부르바키의 『우리는 각자의 세계가 된다』(10분, 67컷)를 만들면서 설정을 바꿔 가며 같은 조건으로 비교했다. 바꾼 것은 세 가지다.
- 5090의 PyTorch를 2.8에서 2.13으로 올렸다(CUDA 12.9 → 13.0).
- ck attention을 켰다. ComfyUI의
--use-ck-attention옵션으로, attention 계산을 다른 커널로 돌린다. 5090과 Spark 모두 켰다. - LTX 모델을 메모리에 상주시켰다. 벤치마크용으로 넣어 둔, 작업마다 모델을 내리는 노드를 제작에서는 뺐다.
같은 프롬프트와 시드로 107프레임 H3를 모델 적재부터 돌려 보니(cold) 5090은 187.6초에서 torch 2.13만으로 108.7초, ck attention까지 켜서 65.9초가 됐다. 프레임 수가 같은 226프레임 본편 장면(warm)에서는 518.4초 → 341.2초 → 182.6초로, 2.84배였다. Spark는 H3가 1.2~1.4배, LTX가 1.16배 빨라졌다. 5090에서 효과가 특히 컸는데, ck attention 커널이 이 세대 GPU에서 기본 경로보다 훨씬 빠른 것으로 보인다. 다만 로그만으로 원인을 확정하지는 않았다.
빨라진 대신 화면이 망가지면 소용없다. 같은 시드로 만든 영상은 설정을 바꿔도 구도와 동작이 같았고 세부만 조금 달랐다. 구조 유사도(SSIM)는 0.888~0.937이었고, 깨짐이나 노이즈가 늘어난 곳은 보이지 않았다.
결과
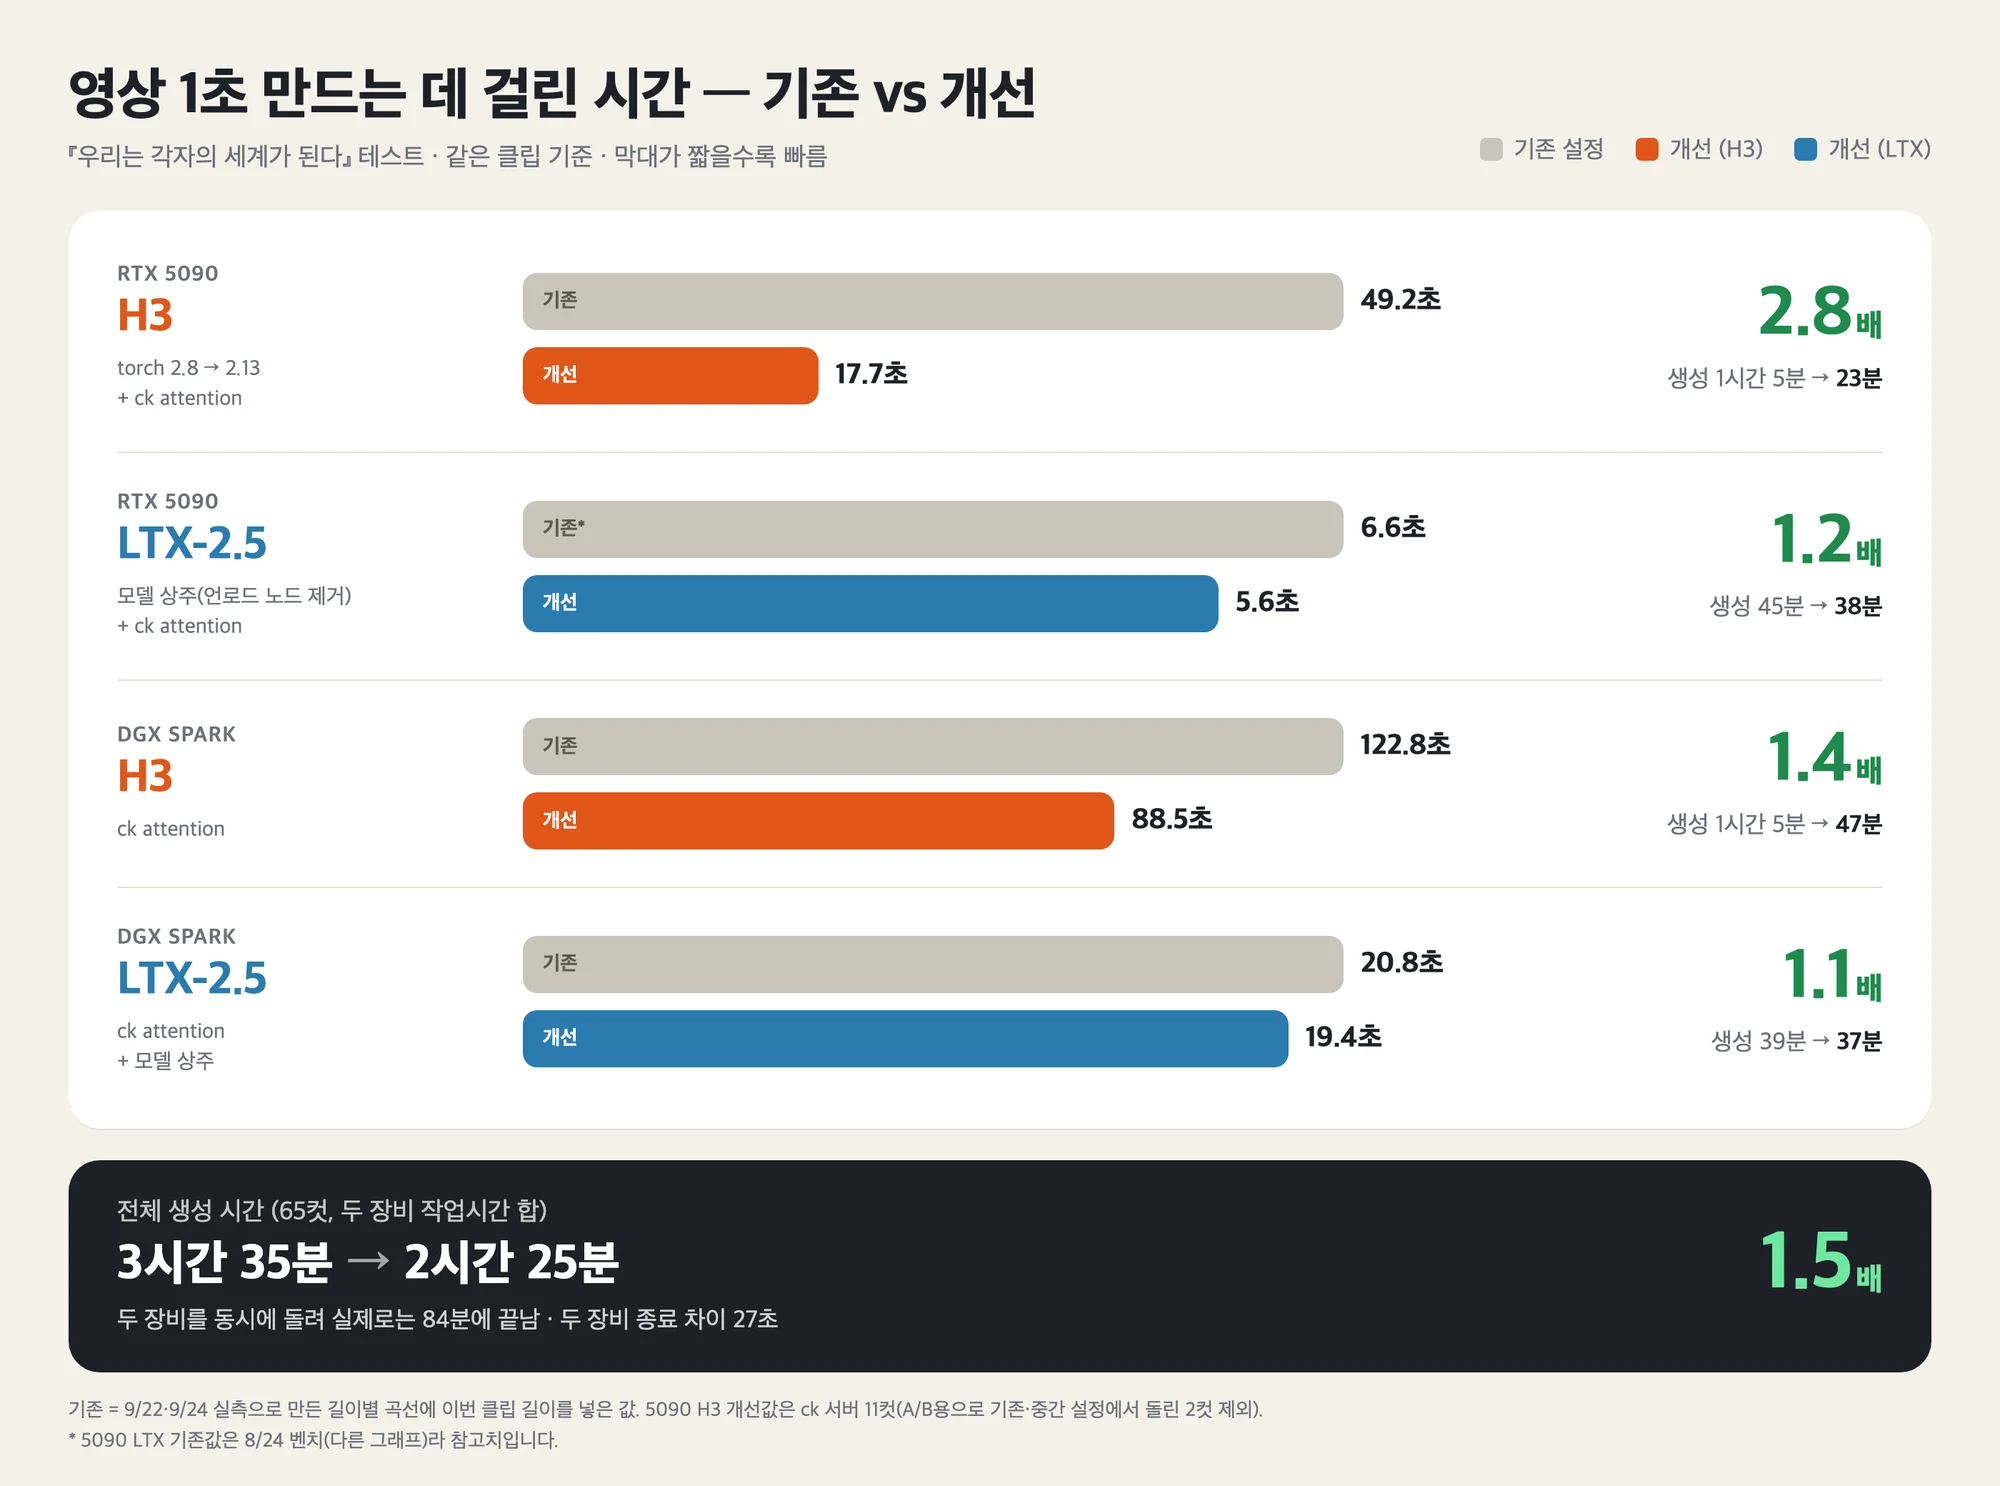
맨 위 그래프가 이 결과다. A/B 비교용 2컷을 뺀 본편 65컷 기준이고, 기존 값은 옛 설정의 실측으로 만든 길이별 곡선에 이번 클립 길이를 넣어 계산했다. 5090 LTX의 기존 값은 그래프가 다른 8월 벤치마크라 참고치다.
| 장비 · 모델 | 기존 | 개선 | 배율 |
|---|---|---|---|
| RTX 5090 · H3 | 49.2초 | 17.7초 | 2.8배 |
| RTX 5090 · LTX 2.5 | 6.6초 | 5.6초 | 1.2배 |
| DGX Spark · H3 | 122.8초 | 88.5초 | 1.4배 |
| DGX Spark · LTX 2.5 | 20.8초 | 19.4초 | 1.1배 |
두 장비의 작업 시간을 합치면 3시간 35분이 2시간 25분이 됐다. 두 장비를 동시에 돌렸으니 실제로 기다린 시간은 84분이었고, 두 장비는 27초 차이로 끝났다.
두 장비에 나눠 싣는 법
끝나는 시간을 맞춘 것은 배분 방식이었다. H3 작업을 길이순으로 줄 세워 5090은 짧은 쪽부터, Spark는 긴 쪽부터 가져가게 했고, 둘 다 H3를 끝내면 공용 LTX 큐에서 남은 일을 나눠 가져가게 했다. 설정을 바꾸기 전 속도로 계산한 계획은 127분이었는데, 속도 추정이 틀려도 큐가 알아서 흡수해 84분에 끝났다. 가동률은 5090 98%, Spark 99.6%였다.
그런데 5090이 빨라지면서 두 장비의 비교우위가 바뀌었다. 같은 H3 작업에서 두 장비의 차이가 2배에서 4.4~4.8배로 벌어졌고, LTX 차이(3.5배)보다 커졌다. 이번에 Spark는 긴 H3 3컷에 47분을 썼다. 다음 편부터는 H3를 모두 5090에 두고 Spark에는 LTX만 맡기는 편이 조금 더 빠르다.
길이가 비용을 결정한다
H3는 클립이 길어지면 시간이 제곱에 가깝게 늘었다. 처음 장면표(46컷, 평균 13초)를 그대로 쓰면 H3 클립이 243~430프레임이 되고, Spark의 예상 시간만 9시간이 넘었다. 5090도 277프레임을 넘기면 VRAM이 모자라 급격히 느려진다. 그래서 H3는 손과 몸 동작이 꼭 필요한 16컷만 10초 이하로 남기고, 나머지는 길이에 거의 비례하는 LTX로 옮겨 67컷으로 다시 나눴다. 모델을 바꾸는 것보다 장면을 어떻게 자르느냐가 시간을 더 크게 바꿨다.
속도와 별개로 남은 것
빨리 만든 클립 중 7컷은 다시 만들었다. 화면 아래에 가짜 자막 글자가 생긴 것이 3컷, 검은 테두리가 생긴 것이 3컷이었다. 가짜 자막은 모든 장면에 붙이는 공통 스타일 문구에 들어 있던 “subtitles”라는 단어가 원인으로 보였고, 그 단어를 뺀 뒤로는 다시 나오지 않았다. 늑대 장면은 LTX로 두 번 다시 만들어도 테두리가 남아 H3로 바꿨다. 이번에는 생성 직후 모든 클립을 글자 인식(Vision OCR)과 테두리 검사(cropdetect)로 훑어 이런 컷을 찾아냈다. 다음부터는 이 검사를 생성 단계에 자동으로 붙일 생각이다.
정리
- 모델과 스텝을 바꾸기 전에 실행 환경(PyTorch 버전, attention 커널)부터 본다. 5090에서는 이쪽 차이가 더 컸다.
- 설정 효과는 같은 프롬프트·시드·길이로 cold와 warm을 나눠 비교한다.
- H3는 길이에 따라 비용이 가파르게 늘어나니, 장면을 10초 이하로 설계한다.
- 두 장비는 길이순 큐와 공용 큐로 나누면 추정이 틀려도 끝 시각이 맞는다.
- 한 장비가 빨라지면 비교우위가 바뀐다. 배분 규칙도 속도를 잰 뒤 다시 정한다.