스파크 활용 · 1화
DGX Spark의 Qwen3.8이 하루 딥리서치 31건을 썼다: 10월 1일 시황 뉴스를 한 건씩 조사한 보고서
10월 1일 AC 시황 오전판 뉴스 14건, 오후판 17건을 DGX Spark에서 돌리는 Qwen3.8 Flash Next가 한 건씩 웹으로 조사해 칼럼 양식 보고서로 썼다. 한 편에 평균 13분쯤 걸렸다.
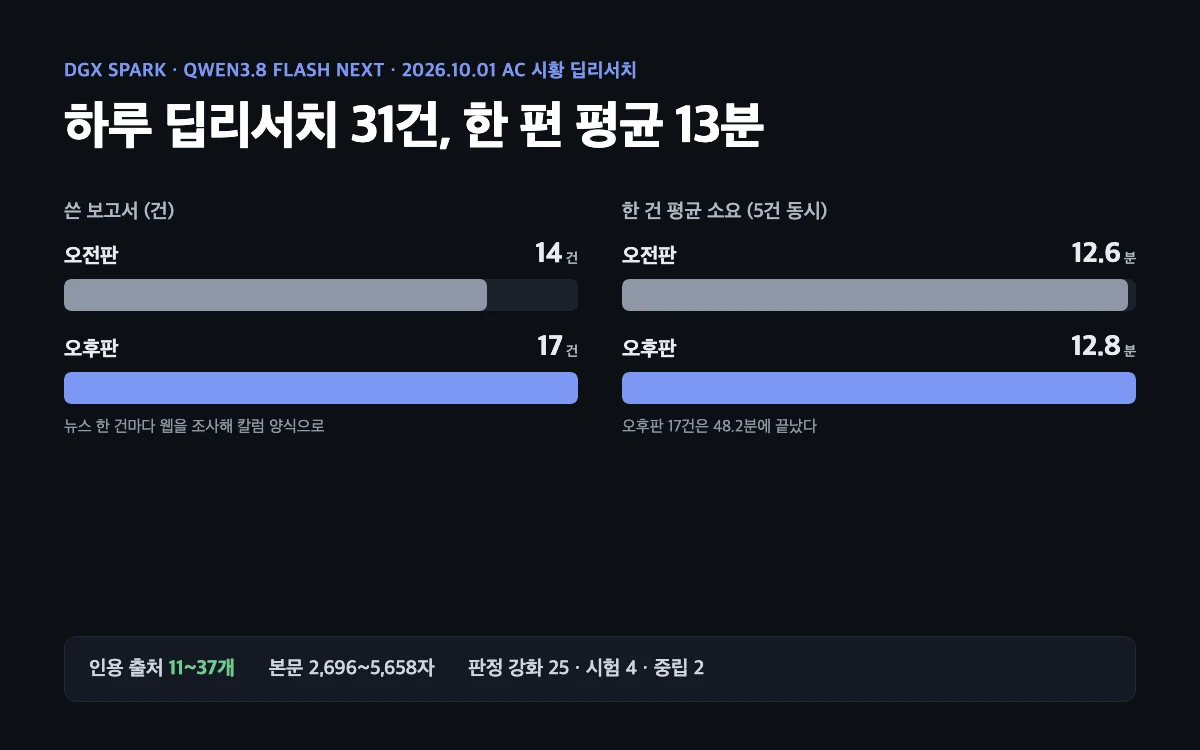
AC 시황은 매일 새벽과 오후에 분야별 뉴스 카드를 올린다. 카드 한 장에는 뉴스의 요지만 들어간다. 이 뉴스가 왜 나왔는지, 숫자가 원문과 맞는지, 반대로 읽을 근거는 없는지는 카드에 담기지 않는다. 그걸 뉴스마다 한 편씩 따로 파 보고 싶었다.
10월 1일에 그걸 처음으로 하루치 전부 돌렸다. 오전판 뉴스 14건, 오후판 뉴스 17건, 합쳐서 31건이다. 보고서를 쓴 건 클라우드 모델이 아니라 DGX Spark 한 대에서 돌아가는 Qwen3.8 Flash Next다. 이 연재는 Spark로 실제 일을 시켜 본 기록이고, 1화는 그 딥리서치 이야기다.
오전판 14건과 오후판 17건이 모두 보고서가 됐다
흐름은 단순하다. 시황 카드에 올라온 뉴스 한 건을 받으면 Qwen이 검색어를 정해 웹을 열 번쯤 검색하고, 그중 두세 개에서 아홉 개 페이지를 골라 읽는다. 읽은 내용으로 칼럼 양식의 보고서를 쓴다. 양식은 정해 두었다. 핵심 요약, 무슨 일이 있었나, 해석, 과대평가하면 안 되는 이유, AC리서치가 이 뉴스를 보는 법, 자주 묻는 질문, 용어 풀이와 출처 순서다.
보고서마다 판정도 하나 붙인다. AC리서치는 AI 하이퍼사이클이 온다는 가설을 갖고 있는데, 이 뉴스가 그 가설을 강화하는지, 시험대에 올리는지, 중립인지를 적는다. 그리고 분야별로 다시 묶어 종합 보고서를 한 편씩 쓴다. 오전판은 데이터센터·전력·반도체 3편, 오후판은 원전·가스까지 4편이 나왔다.
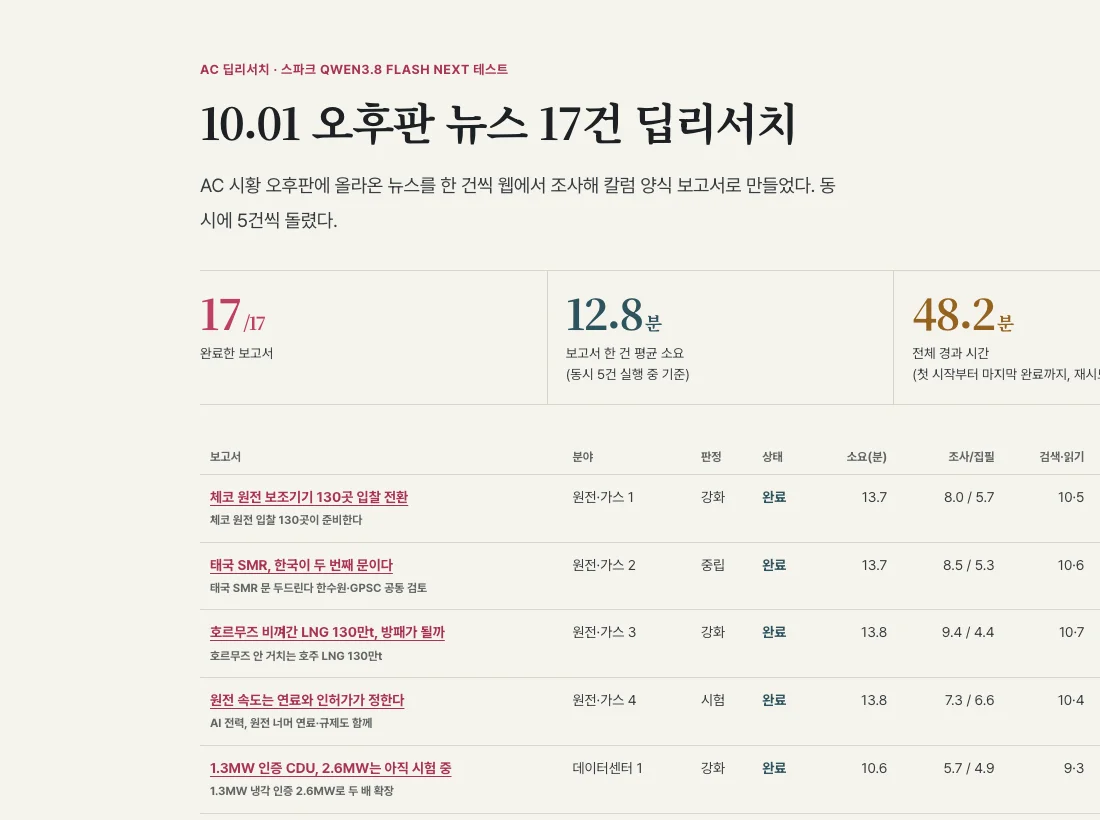
하루치 숫자는 이렇다.
| 오전판 | 오후판 | |
|---|---|---|
| 뉴스(보고서) | 14건 | 17건 |
| 동시에 돌린 건수 | 5건 | 5건 |
| 한 건 평균 소요 | 12.6분 | 12.8분 |
| 전체 경과 시간 | 704.2분 (재시도 포함) | 48.2분 |
| 인용 출처 | 11~35개 | 13~37개 |
| 본문 자수 | 2,902~4,212자 | 2,696~5,658자 |
| 판정 | 강화 12, 시험 2 | 강화 13, 시험 2, 중립 2 |
모델 설정은 vLLM, MTP=2, 한국어 단어표를 붙인 구성이다. 보고서 한 편에 모델을 8~12번 부르고, 읽은 페이지까지 합쳐 입력이 8만~24만 토큰, 출력이 7,800~1만2천 토큰쯤 된다. 오전판의 전체 경과 시간이 길게 찍힌 건 재시도까지 다 들어간 기록이라서다. 깨끗하게 한 번에 돈 건 오후판이다.
GPU 가동률 보고서는 원문을 못 찾은 숫자를 못 찾았다고 적었다
오후판에서 가장 빨리 끝난 보고서 한 편을 그대로 올려 둔다. GPU를 사도 놀면 돈이 된다다. 정부가 민간 클라우드에서 빌려 산학연에 나눠 준 GPU의 70% 넘게가 가동률 50%를 밑돌았다는 뉴스를 조사했다.
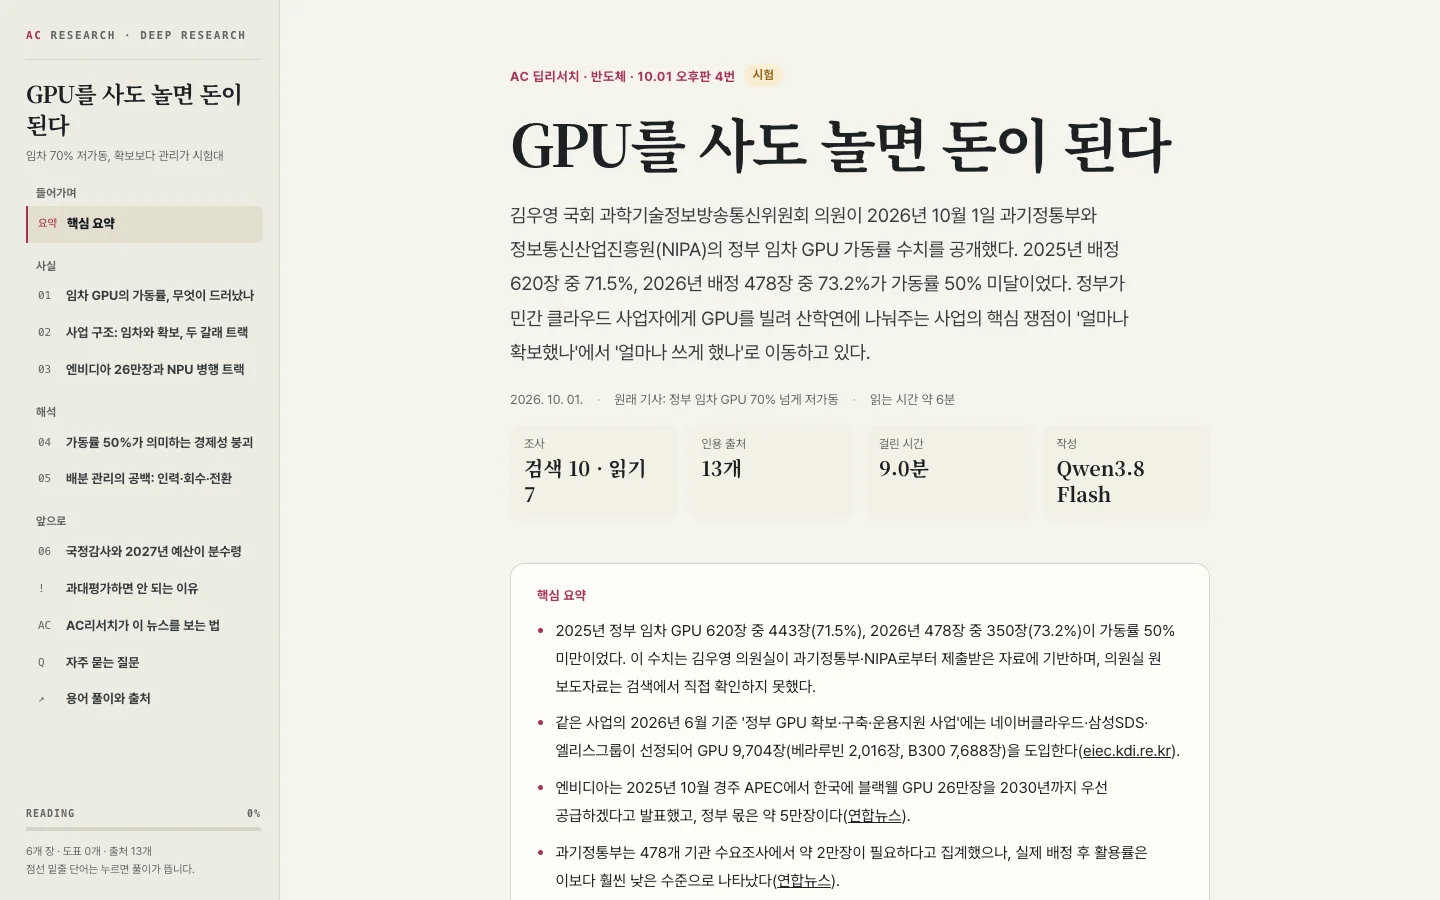
이 한 편에 9.0분이 걸렸다. 조사 5.8분, 집필 3.2분이다. 웹 검색 10번, 페이지 읽기 7번을 했고, 조사하면서 본 출처 53개 중 13개를 인용했다. 입력은 18만 토큰, 출력은 9,909토큰이었다.
읽으면서 좋았던 건 확인한 것과 못 한 것을 나눠 적는 습관이다. 가동률 수치의 1차 출처인 국회의원실 보도자료는 웹에서 원문을 찾지 못했다고 본문에 그대로 썼다. 시황 카드에 있던 2027년 GPU 예산 수치도 1차 출처에서 확인하지 못했다고 적고 넘어갔다. 카드 문장을 사실처럼 옮겨 적지 않았다.
숫자 하나하나는 맞았고 숫자를 엮는 곳에서 틀렸다
그렇다고 바로 믿고 쓸 수 있는 건 아니다. 오전판의 자빌 보고서는 AC리서치에 리서치로 올리기 전에 1차 자료와 하나씩 대조했다. 보도자료에 있는 매출, 주당순이익, 다음 해 가이던스, 그날 종가는 전부 맞았다.
틀린 곳은 숫자를 서로 엮는 대목이었다. 월가 예상을 넘긴 17.1억 달러는 전체 매출 기준인데 AI 매출에 붙였다. 올해 AI 매출은 6월에 내놓은 전망치 136억 달러를 그대로 썼지만 실제로는 약 144억 달러였다. 전체 매출 순증 85억 달러를 AI 매출 순증으로 적었는데 AI 쪽만 보면 약 77억 달러다. 큰 오류 5건을 고친 뒤에야 게시했다.
로컬 모델이 쓴 딥리서치는 출발점으로는 쓸 만하다. 다만 숫자와 숫자 사이의 관계는 사람이든 다른 모델이든 한 번 더 봐야 한다.
반대편 연구원을 붙이자 세 건 모두 결론이 약해졌다
같은 날 오후에는 실험을 하나 더 했다. 오전판 보고서 중 세 건을 골라, 주 연구원이 쓴 결론을 반대편 연구원이 반박하게 했다. 이건 동시에 한 건씩 돌렸다.
세 건 모두 반대편 검토 결과가 약화였고 결론을 고쳤다. 자빌은 매출 성장의 상당 부분이 부품 가격을 그대로 넘긴 효과일 수 있다는 반론이 붙었다. 전력 보고서는 자금 조달의 발목을 잡는다던 산불 책임 문제가 이미 캘리포니아 법(SB 254)으로 상당 부분 완화됐다는 지적을 받았다. 마이크론은 실적과 다음 분기 가이던스가 이미 9월 30일에 나와 예상을 넘겼으니, 가이던스가 분기점이라는 틀 자체가 늦었다는 지적을 받았다.
대신 무거워졌다. 반대편을 붙이면 한 편에 17.5~19.0분이 걸렸고 출력 토큰도 2만5천~4만2천으로 보통 보고서의 2.5~4배가 됐다.
다음 화는 속도다: 다섯 건을 동시에 돌리는 쪽이 빨랐다
하루 31건을 돌리면서 제일 신기했던 건 속도였다. 한 건씩 차례로 돌리는 것보다 다섯 건을 한꺼번에 돌릴 때 전체가 훨씬 빨리 끝났다. 2화에서 그 숫자를 정리한다.
스파크 활용 · 전 10화
- 1화DGX Spark의 Qwen3.8이 하루 딥리서치 31건을 썼다: 10월 1일 시황 뉴스를 한 건씩 조사한 보고서
- 2화DGX Spark는 한 건씩보다 다섯 건을 동시에 돌릴 때 빨랐다: 딥리서치 17건을 48분에 끝냈다
- 3화DGX Spark 2번을 한 시간 반 만에 1번과 똑같이 세웠다: 같은 시드 영상 313초 대 319초
- 4화DGX Spark 두 대가 책 704권을 나눠 정리한다: 속도가 달라 보인 건 원문을 읽던 순간이었다
- 5화DGX Spark를 두 대로 늘리자마자 엔비디아가 두 대를 묶으면 대역폭이 두 배라고 발표했다
- 6화DGX Spark 두 대가 24.6시간 만에 책 404권을 끝냈다: 글자로는 34.6%, 그 뒤 78권은 다시 돌린다
- 7화DGX Spark 두 대가 70시간 동안 책 지도 760권을 만들었다: 토큰 3억 5,800만 개, 함께 돌 때 초당 306토큰
- 8화스파크 한 대당 동시 24개가 스윗스팟이었다: 짧은 일감 분당 32.4건, 32개부터는 처리량은 그대로고 실패만 늘었다
- 9화맥스튜디오는 요청 하나에, 스파크는 일괄 작업에 강했다: 단독 51~66 대 37토큰, 최고 처리량 117 대 163토큰
- 10화맥·스파크·5090에서 돌려본 Qwen3.8 Flash Next