스파크 활용 · 5화
DGX Spark를 두 대로 늘리자마자 엔비디아가 두 대를 묶으면 대역폭이 두 배라고 발표했다
스파크를 한 대 더 들인 바로 그날, 엔비디아가 DGX Spark 64GB를 발표했다. 뉴스의 핵심은 64GB가 아니라 두 대를 케이블로 이으면 메모리 대역폭이 두 배가 된다는 점이다. 128GB도 네 대까지 묶이고, 10월 말 Model Launcher가 나오면 클릭 몇 번으로 나눠 돌린다. 다만 가격은 비싸다.
3화에서 DGX Spark를 한 대 더 들였다. 두 대를 고속 케이블로 묶는 방법도 있지만 당장은 따로 쓰기로 했다. 그런데 같은 10월 2일(미국 시각), 엔비디아가 DGX Spark 64GB를 발표했다. 처음엔 메모리를 줄인 보급형 소식인 줄 알았다. 읽어 보니 이미 128GB 두 대를 가진 나에게 좋은 소식이었다. 엔비디아 블로그와 NVIDIA Sync 설명서, 마켓플레이스 가격을 확인해 카드뉴스 11장으로 정리했고, 이 글은 그 내용이다.
64GB 출시보다 중요한 건 두 대를 이으면 대역폭이 두 배라는 점이다
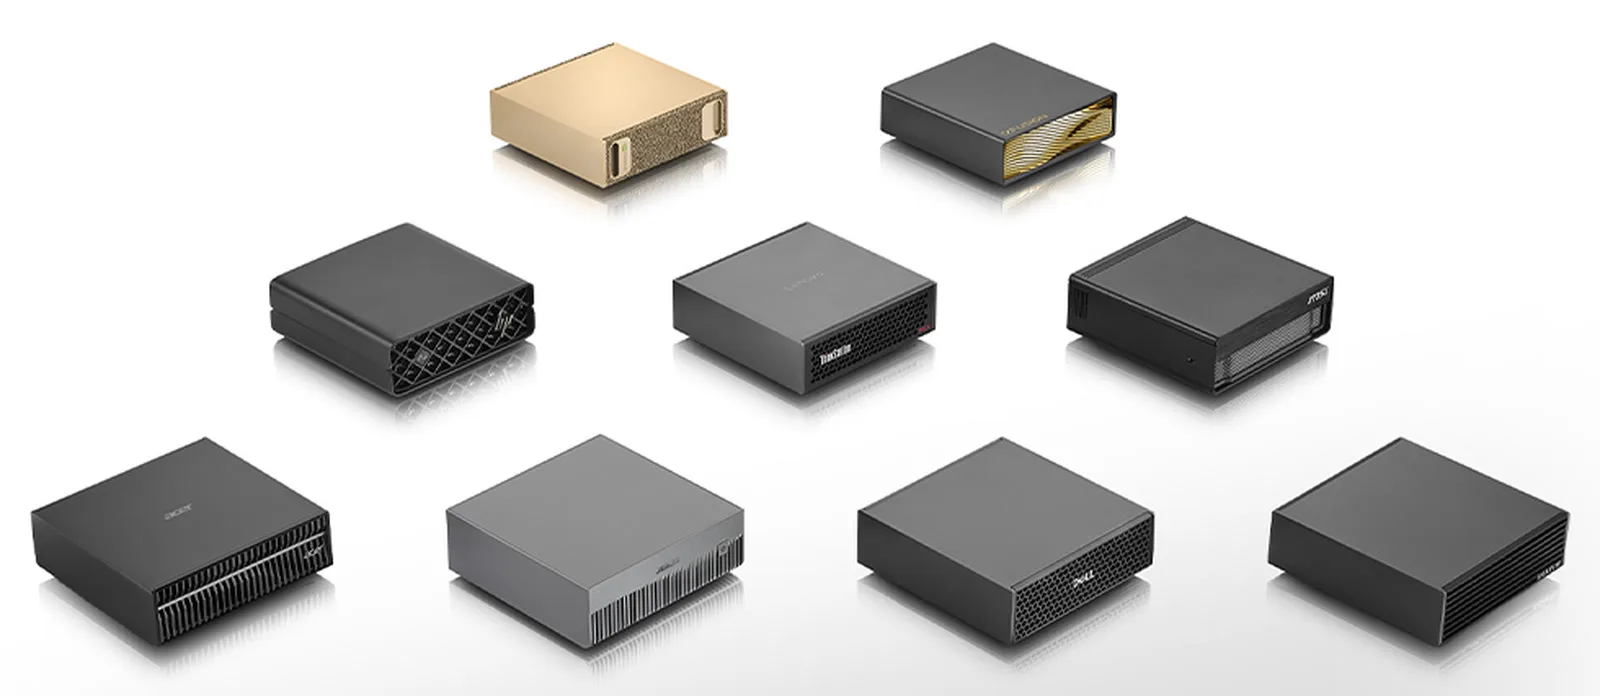
발표 내용은 이렇다. DGX Spark 64GB는 10월 23일에 Acer, ASUS, Dell, Gigabyte, HP, MSI가 $4,999부터 판다. GB10 칩과 DGX OS, 소프트웨어는 128GB 모델과 같고, 한 대로 최대 1,000억(100B) 파라미터 모델을 돌린다.
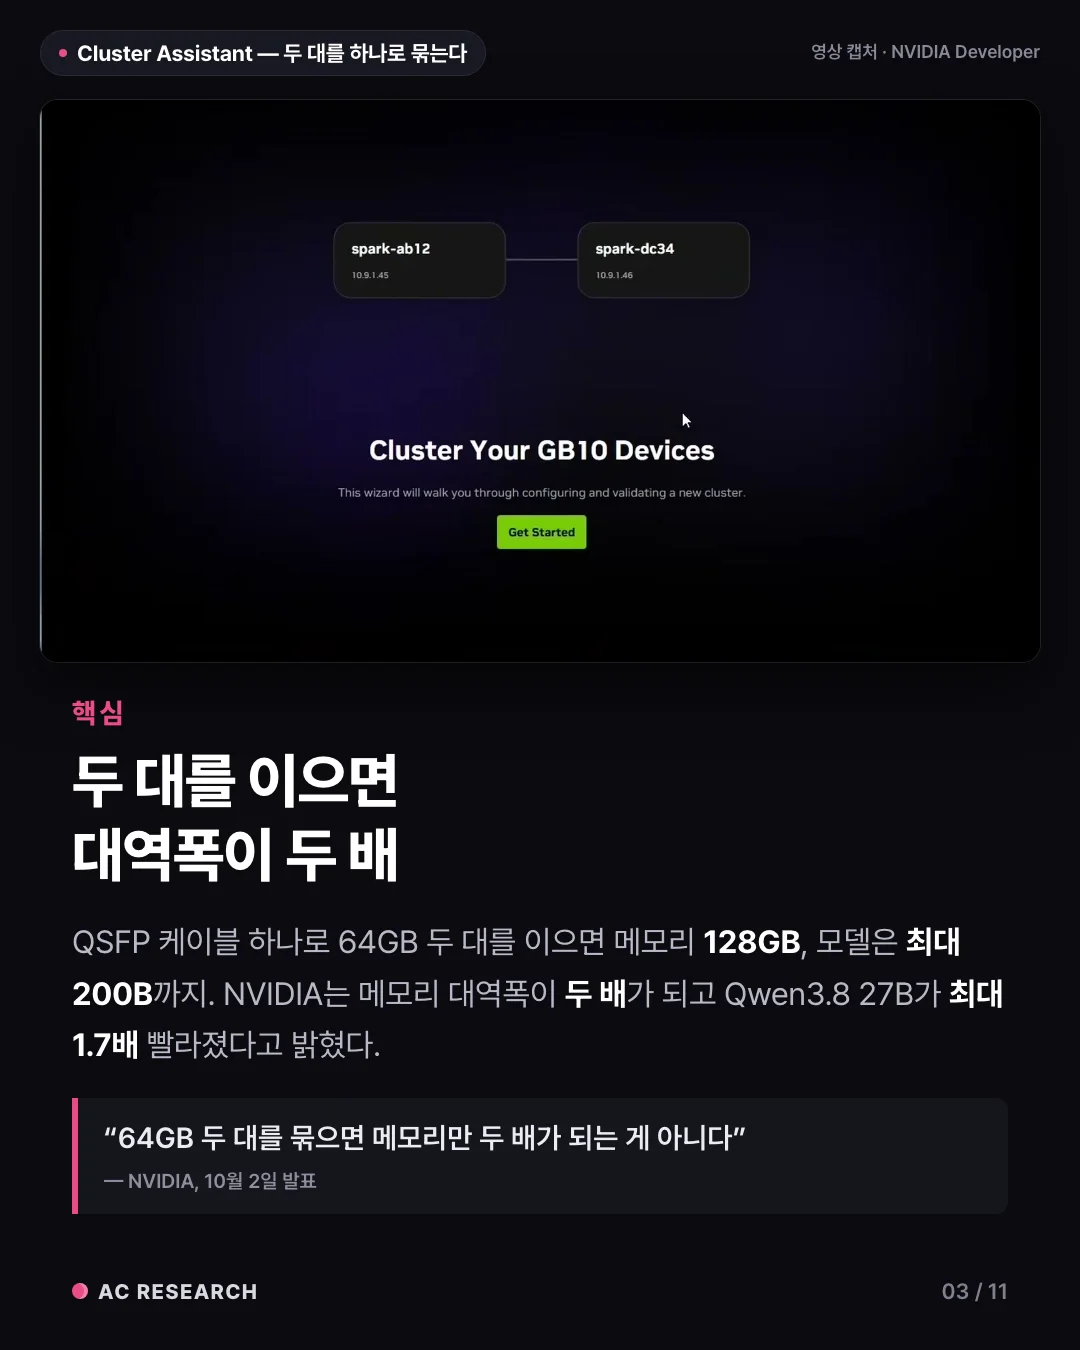
진짜 뉴스는 그다음 문단에 있었다. QSFP 케이블 하나로 64GB 두 대를 이으면 메모리는 128GB가 되고 모델은 최대 2,000억(200B) 파라미터까지 올라간다. 엔비디아는 이때 메모리 대역폭이 두 배가 되고 Qwen3.8 27B가 최대 1.7배 빨라졌다고 밝혔다. 메모리 용량만 두 배가 되는 게 아니라 속도도 같이 오른다는 이야기다.
대역폭이 곧 속도인 이유는 LLM이 토큰마다 가중치를 전부 읽기 때문이다
LLM은 토큰 하나를 만들 때마다 메모리에 올린 가중치를 처음부터 끝까지 읽는다. 그래서 글을 쓰는 속도의 천장은 계산 능력보다 메모리에서 읽어 오는 속도, 곧 메모리 대역폭이다. 스파크 한 대의 메모리 대역폭은 273GB/s다.
두 대로 묶으면 모델 가중치를 반씩 나눠 올리고 두 대가 동시에 읽는다(텐서 병렬화). 한 대가 토큰마다 읽어야 할 양이 절반이 되니 이론상 두 배 빨라진다. 다만 두 대 사이의 연결은 200Gb/s, 바이트로 약 25GB/s다. 한 대 안의 메모리보다 열 배 넘게 느리다. 토큰마다 두 대가 중간 결과를 주고받아야 해서, 실측은 두 배가 아니라 최대 1.7배에 그친다.
128GB도 묶이고 네 대까지 간다, 네 대부터는 스위치가 필요하다
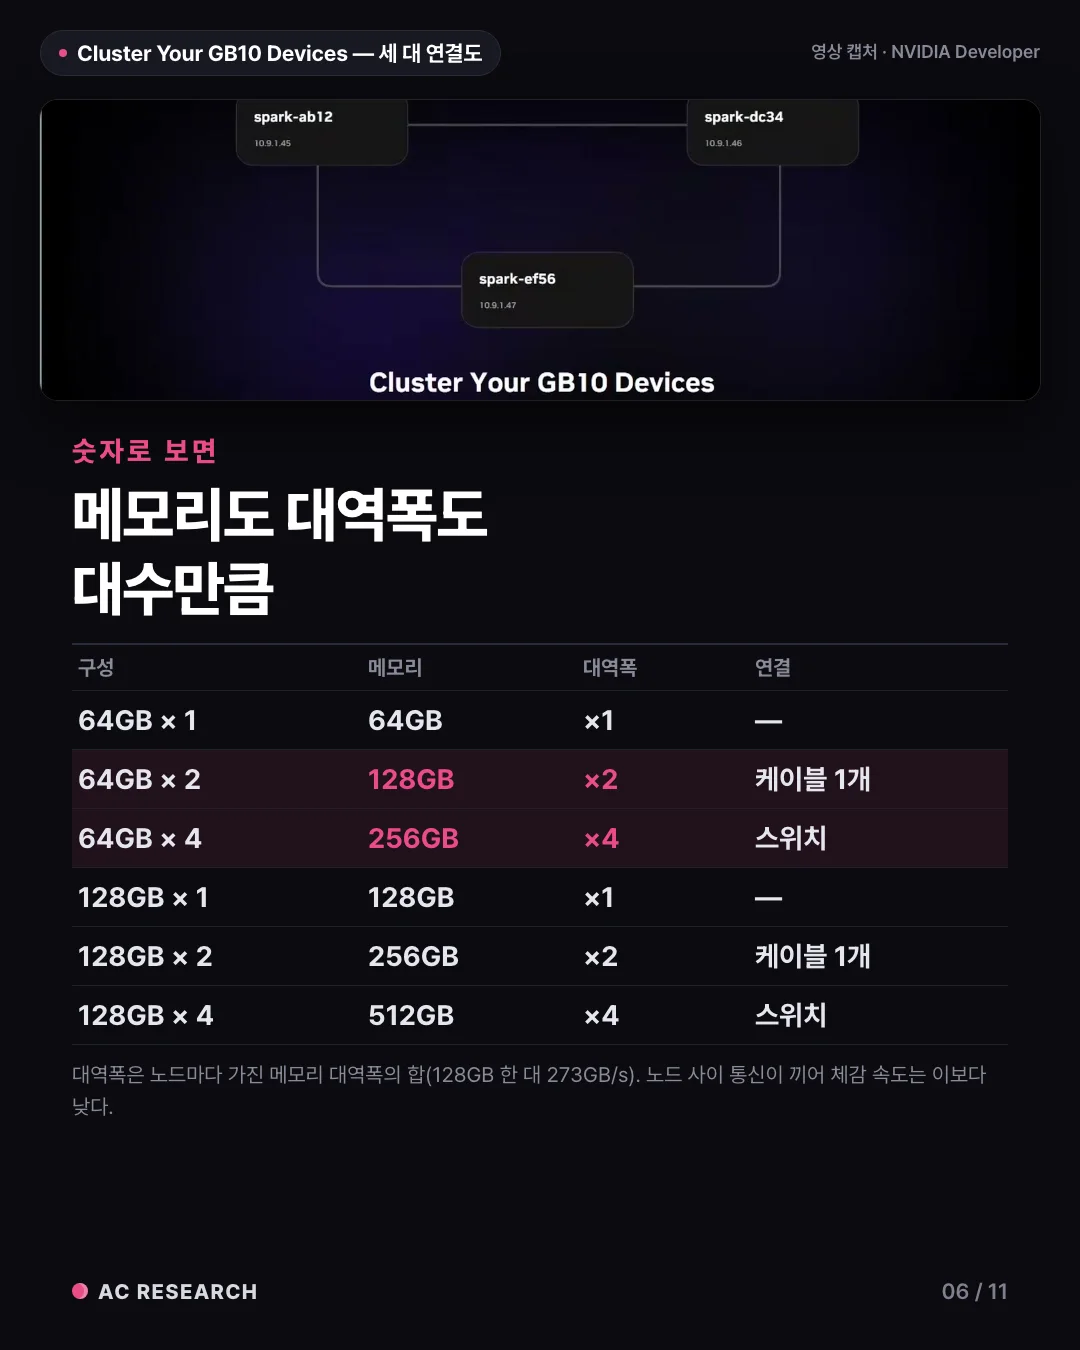
이건 64GB만의 이야기가 아니다. NVIDIA Sync 설명서를 보면 Cluster Assistant는 스파크 2~4대를 묶는다. 두 대와 세 대는 케이블로 바로 잇고(세 대는 서로 이어 고리 모양), 네 대는 200GbE 스위치가 있어야 한다. 128GB 네 대면 메모리 512GB, 7,000억(700B) 파라미터급 모델까지 간다.
대수를 늘리면 속도도 따라온다. 엔비디아가 3월 19일 기술 블로그에서 잰 Llama 3.3 70B의 토큰당 생성 시간은 한 대 269ms, 두 대 133ms, 네 대 72ms였다.
그래서 64GB를 사는 이유는 용량이 아니라 늘릴 수 있는 대역폭이다
용량만 보면 128GB 한 대가 낫다. 한 대에 다 들어가는 모델이라면 한 대가 가장 단순하고, 클러스터에는 설정과 통신 비용이 따른다. 그래서 64GB의 의미는 싸게 사는 데 있지 않다. 작게 시작해 한 대씩 붙이며 대역폭을 키우는 데 있다. 64GB 한 대에서 두 대로 가면 128GB에 대역폭 두 배, 네 대로 가면 256GB에 네 배다. 엔비디아도 지금 필요한 메모리로 시작해서 클러스터로 넓혀 가라고 권한다.
10월 말 Model Launcher가 나오면 플레이북 대신 버튼으로 나눠 돌린다
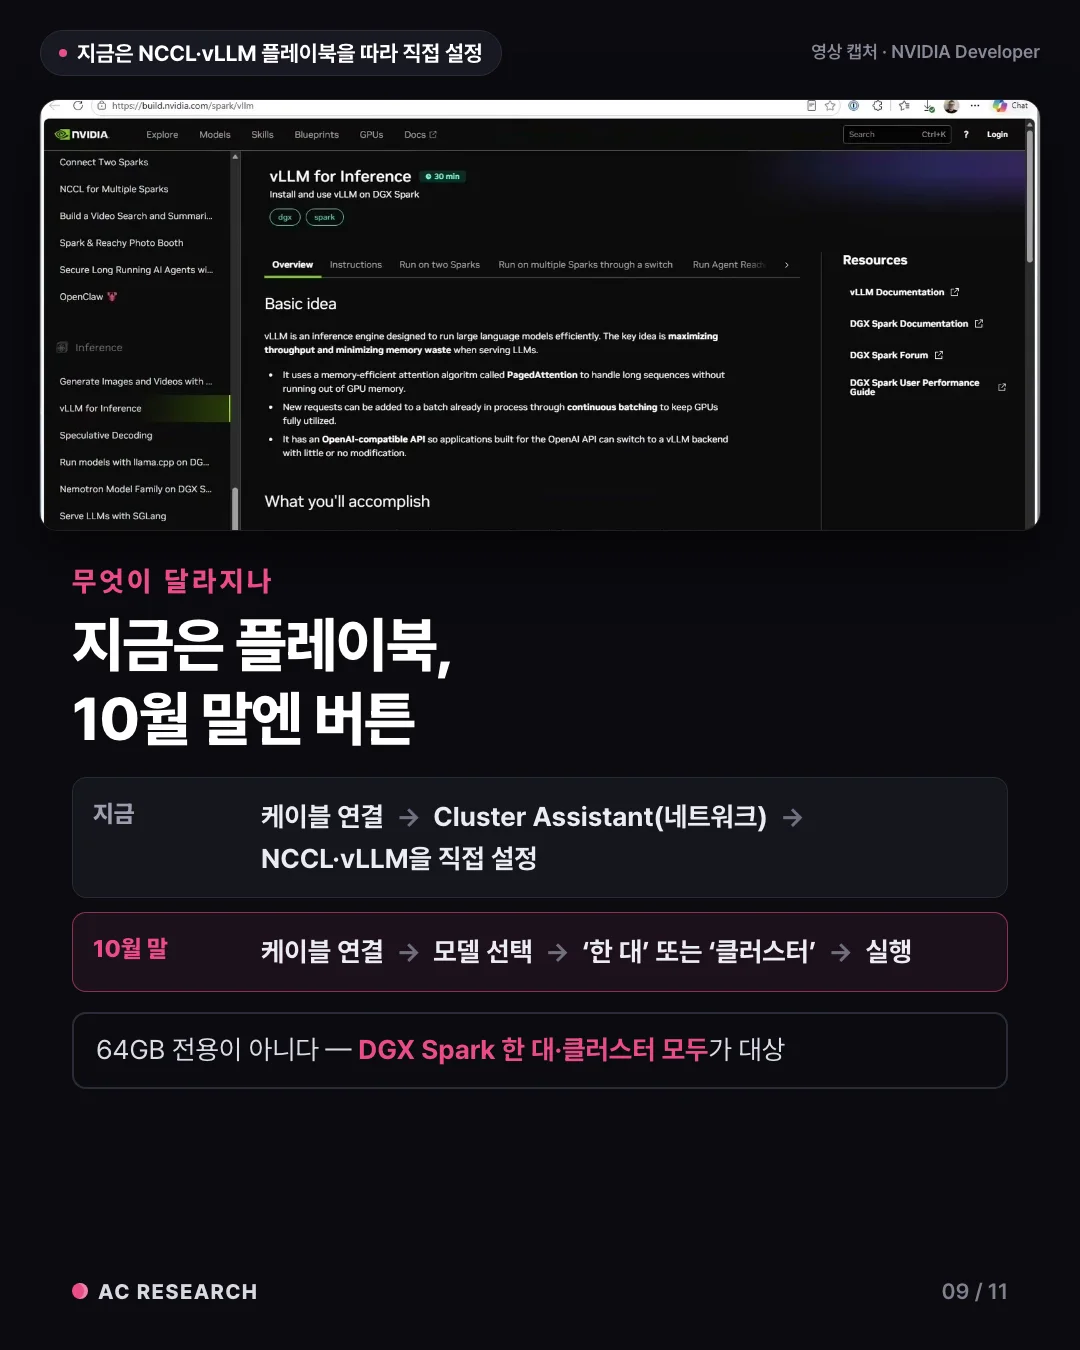
지금 있는 Cluster Assistant는 네트워크까지만 잡아 준다. 연결된 기기를 찾고, 설정을 검사하고, ConnectX-7 네트워크를 구성한다. 그 위에서 모델을 두 대에 나눠 돌리려면 엔비디아 플레이북을 따라 NCCL과 vLLM을 직접 설정해야 한다.
엔비디아는 이달 말 NVIDIA Sync Model Launcher를 내놓는다고 했다. 모델을 내려받고 한 대로 돌릴지 클러스터로 돌릴지 고르면, 연결된 장비에 맞춰 나눠 실행해 준다. 64GB 전용 기능이 아니라 한 대짜리 스파크와 클러스터 모두가 대상이다.
다만 가격은 비싸다: 같은 128GB를 64GB 두 대로 맞추면 $3,048을 더 낸다
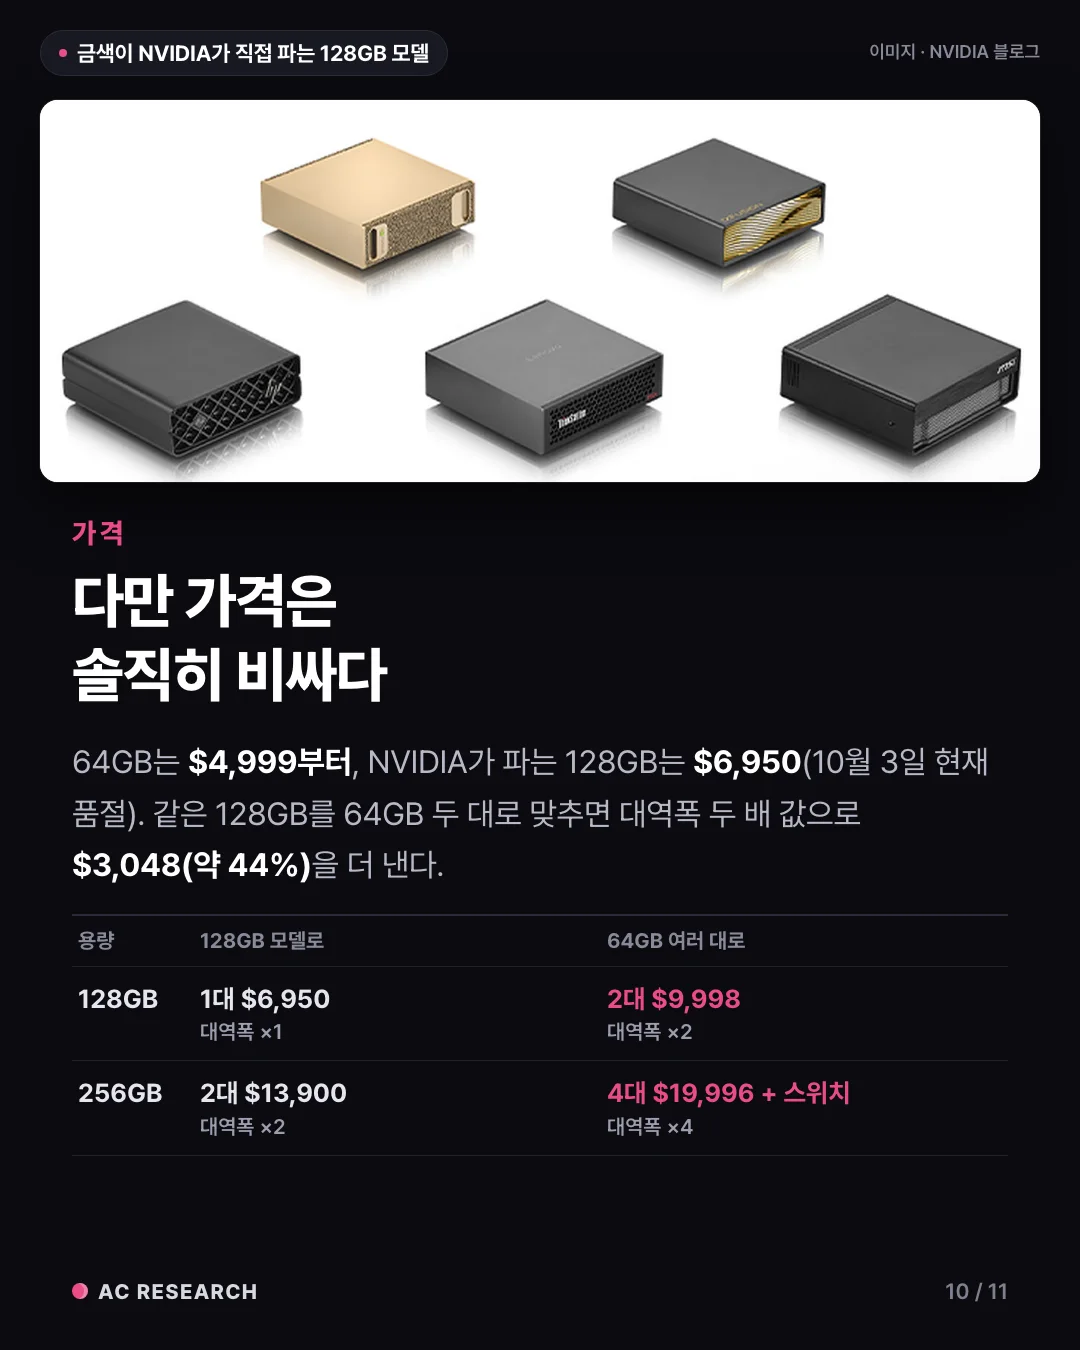
64GB는 $4,999부터다. 엔비디아가 직접 파는 128GB는 10월 3일 마켓플레이스 기준 $6,950이고 품절이었다. 메모리 128GB를 64GB 두 대로 맞추면 $9,998로 128GB 한 대보다 $3,048(약 44%)을 더 낸다. 대역폭 두 배의 값이다. 256GB는 128GB 두 대면 $13,900, 64GB 네 대면 스위치를 빼고도 $19,996이다.
메모리 64GB짜리 기기에 5,000달러는 솔직히 비싸다. 대역폭을 키우는 길이 생긴 건 좋은 소식이지만, 그 길에 드는 값은 가볍지 않다.
내 스파크 두 대는 케이블이 이미 꽂혀 있어 10월 말이면 256GB로 묶을 수 있다
이제 내 쪽 이야기다. 나는 128GB 스파크를 두 대 가졌다. 묶으면 메모리 256GB, 메모리 대역폭 합은 546GB/s다. 두 대 사이 QSFP 케이블은 3화에서 이미 꽂았다. 200Gbps로 바로 붙었지만, 두 포트에 고정 IP가 없어 5분 만에 끊겼다. 직결 포트를 잡아 주는 일이 바로 지금 Cluster Assistant가 하는 일이다. 거기에 10월 말 Model Launcher가 더해지면 한 대에 안 들어가는 큰 모델을 두 대에 나눠 올리는 일이 플레이북 없이 버튼 몇 번이 된다. 새 장비를 하나도 사지 않고 생긴 길이다.
그렇다고 늘 묶어 두지는 않는다. 2화에서 딥리서치는 다섯 건을 동시에 돌릴 때가 더 빨랐고, 4화의 책 704권은 두 대가 따로 나눠 정리한다. 일이 여러 건이면 따로 맡기는 쪽이 낫다. 묶으면 요청 하나가 빨라지고 큰 모델이 들어가는 대신 두 대 사이 통신 값을 낸다. 평소엔 따로 쓰고, 큰 모델 하나를 빠르게 써야 할 때 묶을 수 있게 된 것이 이번 발표가 내게 준 선택지다.
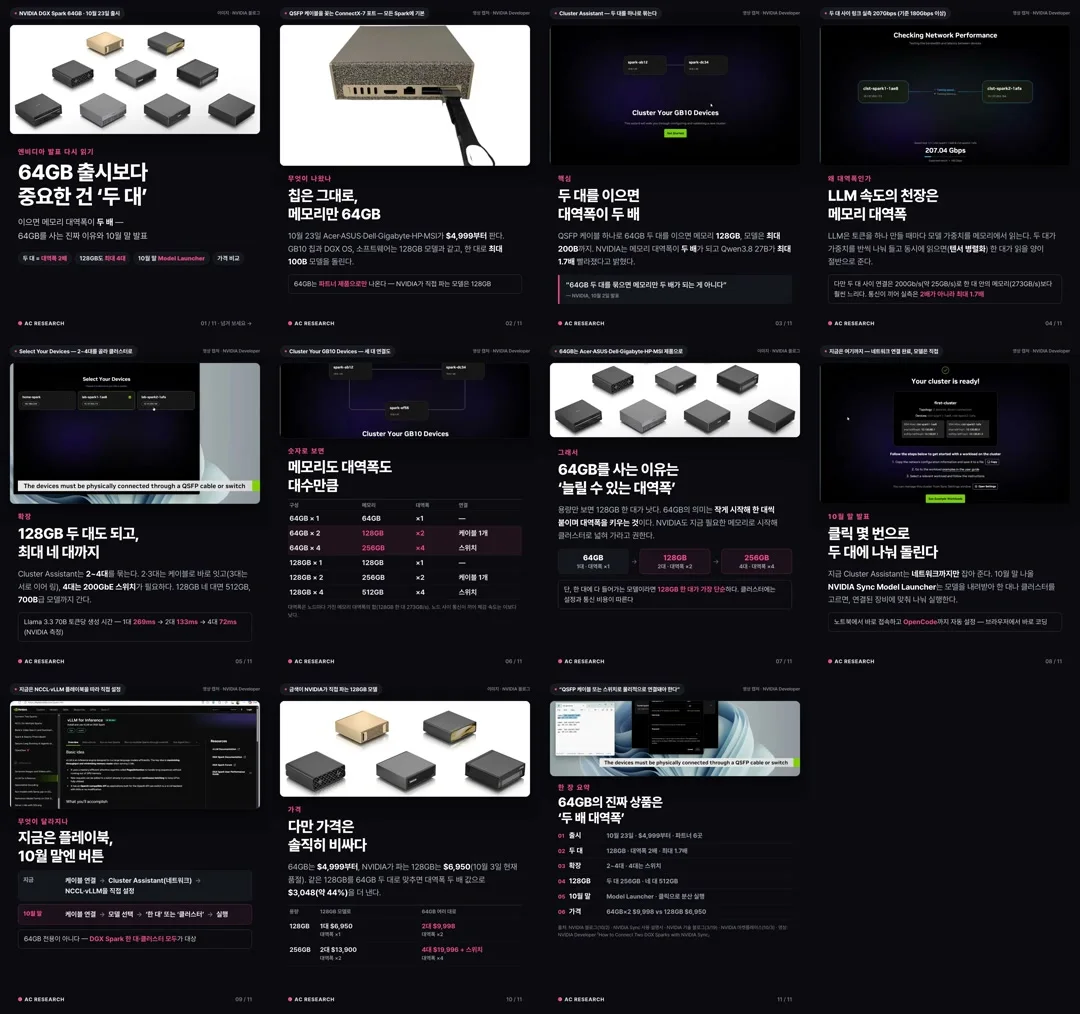
카드뉴스 11장은 엔비디아 원문 네 곳으로 만들었다
배운 것
신제품 발표는 새 제품의 사양보다 이미 가진 장비에 무엇이 생기는지로 읽어야 했다. 64GB 출시는 처음엔 남의 이야기 같았다. 실제로는 두 대를 한 덩어리로 묶는 길이 공식 기능이 된다는 소식이었고, 그 길은 128GB 두 대에도 열려 있었다. 남은 숙제는 3화에서 미뤄 둔 직결 포트 설정이다. 10월 말 Model Launcher가 나오면 두 대를 묶어 큰 모델 하나를 돌려 보고, 엔비디아가 말한 1.7배가 우리 집에서도 나오는지 잰다.
스파크 활용 · 전 10화
- 1화DGX Spark의 Qwen3.8이 하루 딥리서치 31건을 썼다: 10월 1일 시황 뉴스를 한 건씩 조사한 보고서
- 2화DGX Spark는 한 건씩보다 다섯 건을 동시에 돌릴 때 빨랐다: 딥리서치 17건을 48분에 끝냈다
- 3화DGX Spark 2번을 한 시간 반 만에 1번과 똑같이 세웠다: 같은 시드 영상 313초 대 319초
- 4화DGX Spark 두 대가 책 704권을 나눠 정리한다: 속도가 달라 보인 건 원문을 읽던 순간이었다
- 5화DGX Spark를 두 대로 늘리자마자 엔비디아가 두 대를 묶으면 대역폭이 두 배라고 발표했다
- 6화DGX Spark 두 대가 24.6시간 만에 책 404권을 끝냈다: 글자로는 34.6%, 그 뒤 78권은 다시 돌린다
- 7화DGX Spark 두 대가 70시간 동안 책 지도 760권을 만들었다: 토큰 3억 5,800만 개, 함께 돌 때 초당 306토큰
- 8화스파크 한 대당 동시 24개가 스윗스팟이었다: 짧은 일감 분당 32.4건, 32개부터는 처리량은 그대로고 실패만 늘었다
- 9화맥스튜디오는 요청 하나에, 스파크는 일괄 작업에 강했다: 단독 51~66 대 37토큰, 최고 처리량 117 대 163토큰
- 10화맥·스파크·5090에서 돌려본 Qwen3.8 Flash Next