스파크 활용 · 2화
DGX Spark는 한 건씩보다 다섯 건을 동시에 돌릴 때 빨랐다: 딥리서치 17건을 48분에 끝냈다
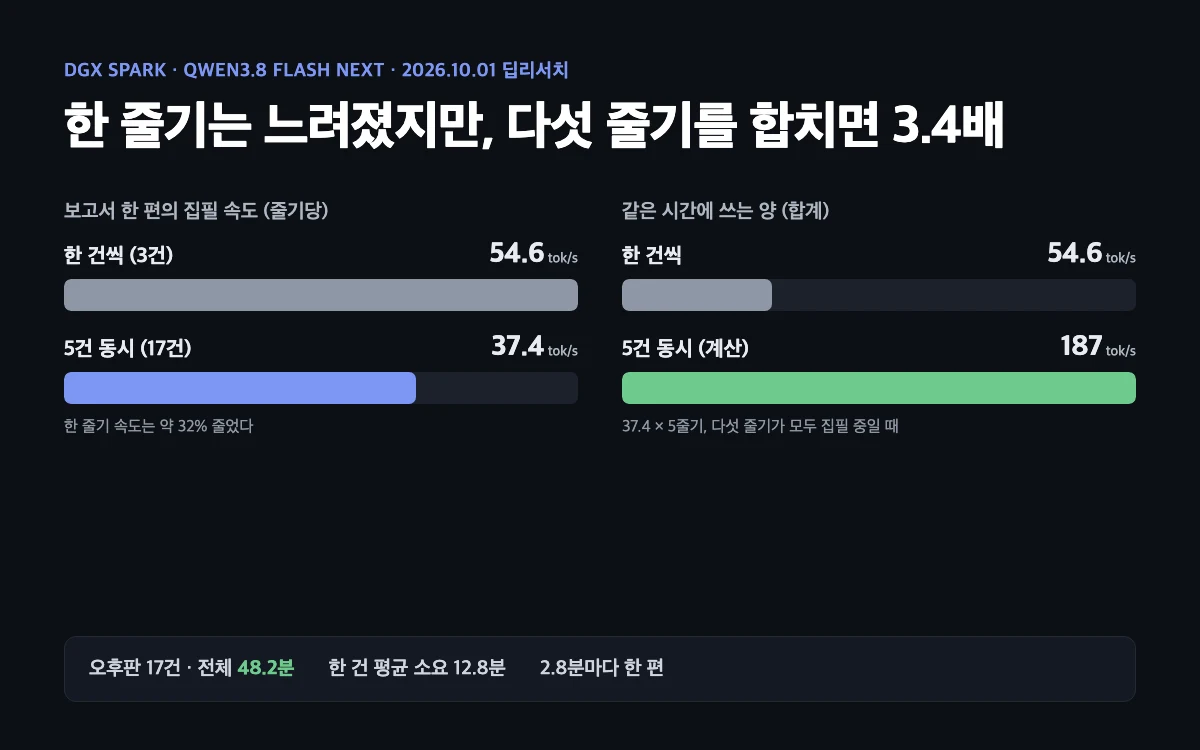
Qwen3.8 딥리서치를 다섯 건씩 동시에 돌리자 보고서 한 편의 집필 속도는 초당 54.6토큰에서 37.4토큰으로 줄었지만, 다섯 줄기를 합치면 같은 시간에 3배 넘게 썼다. 17건이 48.2분에 끝났다.
컴퓨터에 일을 여러 개 동시에 시키면 하나하나가 느려진다. 그래서 결국 걸리는 시간은 차례로 시킬 때와 비슷할 거라고 막연히 생각했다. 1화의 딥리서치를 돌려 보니 DGX Spark는 그렇지 않았다. 다섯 건을 한꺼번에 돌리면 한 건 한 건은 조금 느려지는데, 전체는 훨씬 빨리 끝났다. 이게 신기해서 숫자를 따로 뽑아 봤다.
오후판 17건은 48.2분에 끝났고 한 편은 평균 12.8분 걸렸다
10월 1일 오후판 딥리서치는 뉴스 17건을 다섯 건씩 동시에 돌렸다. 보고서 한 편이 시작해서 끝날 때까지는 평균 12.8분이 걸렸다. 그런데 17건 전체는 첫 시작부터 마지막 완료까지 48.2분 만에 끝났다. 2.8분마다 보고서가 한 편씩 나온 셈이다.
한 편에 12.8분인 일을 17번 차례로 하면 3시간 반이 넘는다. 물론 이건 정확한 비교가 아니다. 12.8분은 다섯 건이 같이 도는 동안 잰 시간이라, 혼자 돌릴 때보다 길다. 그래서 더 공정하게 보려고 보고서 한 편이 글을 쓰는 속도를 따로 봤다.
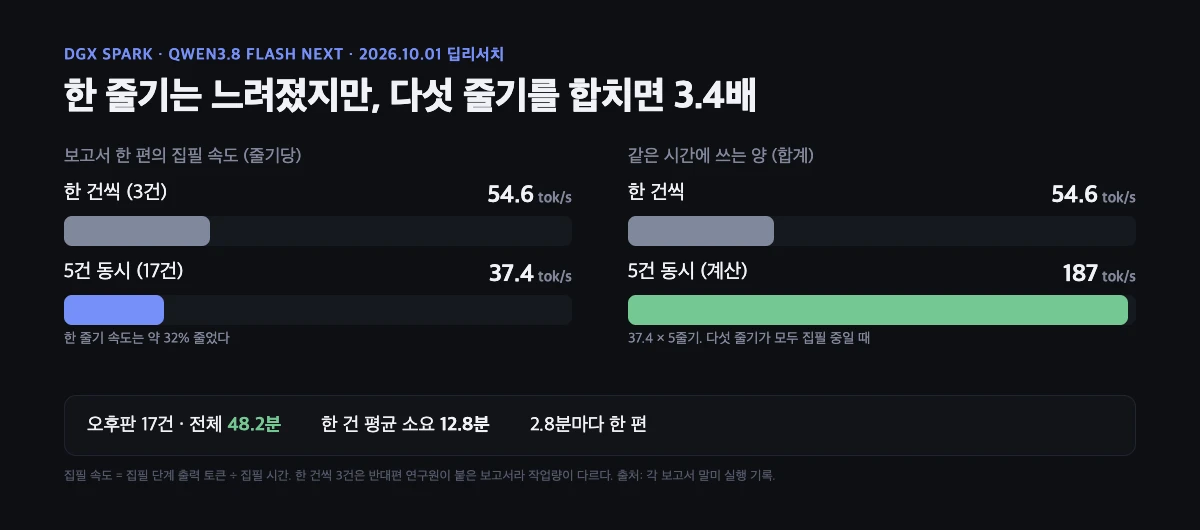
한 줄기 속도는 32% 줄었고 다섯 줄기를 합치면 3.4배였다
보고서마다 끝에 실행 기록이 붙는다. 조사에 몇 분, 집필에 몇 분, 출력 토큰이 몇 개였는지다. 집필 단계의 출력 토큰을 집필 시간으로 나누면 그 보고서가 글을 쓴 속도가 나온다.
| 한 건씩 | 5건 동시 | |
|---|---|---|
| 표본 | 반대편 검증 보고서 3건 | 오후판 보고서 17건 |
| 줄기당 집필 속도 | 초당 54.6토큰 | 초당 37.4토큰 |
| 다섯 줄기 합계(계산) | - | 초당 약 187토큰 |
| 하루치 결과 | - | 17건, 48.2분 |
한 줄기만 보면 다섯 건을 같이 돌릴 때 약 32% 느려졌다. 그런데 그 느려진 줄기가 다섯 개 동시에 돈다. 다섯 줄기가 모두 글을 쓰고 있는 순간이라면 같은 시간에 초당 187토큰, 한 건씩 돌릴 때의 3.4배를 쓴다.
비교 조건이 완전히 같지는 않다. 한 건씩 돌린 3건은 1화에서 말한 반대편 연구원이 붙은 보고서라 출력이 2.5~4배 길다. 표본도 3건뿐이다. 그래도 5건 동시 쪽의 줄기당 속도가 크게 무너지지 않았다는 점은 분명하다.
가중치를 한 번 읽어 다섯 줄기에 나눠 쓰기 때문이다
이유를 찾아보니 Spark가 느린 지점이 계산이 아니라 메모리였다. 언어 모델은 토큰 하나를 만들 때마다 모델 가중치를 메모리에서 읽어 와야 한다. Spark의 메모리는 초당 273GB를 옮긴다. 혼자 글을 쓸 때는 가중치를 한 번 읽고 토큰을 하나 만든다. 다섯 줄기가 같이 쓰면 가중치를 한 번 읽고 다섯 줄기의 토큰을 한꺼번에 만든다. 읽어 오는 시간은 거의 그대로인데 결과물이 다섯 배가 된다.
엘리베이터로 치면 쉽다. 한 명을 태우나 다섯 명을 태우나 10층까지 올라가는 시간은 거의 같다. 혼자 탈 때 엘리베이터는 대부분 빈 채로 오르내리고 있었던 거다. 계산 장치도 마찬가지로 혼자 쓸 때는 메모리를 기다리며 놀고 있었다.
Qwen3.8 Flash Next가 전문가 혼합(MoE) 모델이라는 점도 거든다. 전체는 176B쯤이지만 토큰 하나에 실제로 쓰는 건 6B 안팎이다. 한 번에 읽는 양이 적어서 여러 줄기를 같이 돌려도 여유가 있다.
딥리서치라서 생기는 이득도 있다. 한 편에 걸린 12.8분 중 8분 안팎은 조사 단계다. 웹을 검색하고 페이지를 받아 오는 동안 모델은 할 일이 없다. 다섯 건을 같이 돌리면 한 건이 검색 결과를 기다리는 동안 다른 건이 그 시간에 글을 쓴다.
9월에 모아 둔 커뮤니티 측정에도 같은 모양이 나왔다
Spark를 들이고 9월 22일에 Spark 한 대로 Qwen3.8을 가장 빠르게 돌리는 법을 조사해 둔 적이 있다. NVIDIA 개발자 포럼, 레딧 등에서 사람들이 잰 숫자를 모은 보고서다. 다시 열어 보니 같은 현상이 이미 표에 있었다.
| 측정 | 한 건 | 여러 건 동시 |
|---|---|---|
| Flash Next NVFP4, vLLM, MTP3 (Spark 1대) | 중앙값 초당 32.5토큰 | 6건 합계 초당 194토큰 |
| Flash Next NVFP4, MTP2 (레딧 측정) | 초당 22.2토큰 | 3건 합계 초당 48.7토큰 |
| Qwen3.8-27B NVFP4, SGLang, DFlash2 | 초당 50토큰 | 8건 합계 148, 32건 합계 258 |
27B 쪽 측정에는 대가도 적혀 있었다. 동시 요청이 1건에서 8건으로 늘면 요청 하나의 속도는 초당 47.9토큰에서 27.6토큰으로 줄고, 첫 글자가 나오기까지의 시간도 0.23초에서 0.39초로 늘었다. 내 딥리서치에서 줄기당 속도가 32% 줄어든 것과 같은 방향이다.
급한 한 건은 단독으로, 하루치 묶음은 동시에 돌린다
정리하면 Spark는 한 건을 빨리 끝내는 기계라기보다 여러 건을 같이 소화하는 기계에 가깝다. 하루 30건씩 몰아서 쓰는 시황 딥리서치는 동시 실행이 맞다. 반대로 지금 당장 한 편만 읽고 싶을 때는 혼자 돌리는 편이 그 한 편을 더 빨리 받는다.
영상은 사정이 달랐다. 로컬 영상 뽑기 연재에서 잰 것처럼, 영상 한 컷을 빨리 뽑는 데는 RTX 5090이 앞섰다. 같은 Spark인데 언어 모델 딥리서치에서는 동시에 돌릴수록 이득이 났다.
스파크 활용 · 전 10화
- 1화DGX Spark의 Qwen3.8이 하루 딥리서치 31건을 썼다: 10월 1일 시황 뉴스를 한 건씩 조사한 보고서
- 2화DGX Spark는 한 건씩보다 다섯 건을 동시에 돌릴 때 빨랐다: 딥리서치 17건을 48분에 끝냈다
- 3화DGX Spark 2번을 한 시간 반 만에 1번과 똑같이 세웠다: 같은 시드 영상 313초 대 319초
- 4화DGX Spark 두 대가 책 704권을 나눠 정리한다: 속도가 달라 보인 건 원문을 읽던 순간이었다
- 5화DGX Spark를 두 대로 늘리자마자 엔비디아가 두 대를 묶으면 대역폭이 두 배라고 발표했다
- 6화DGX Spark 두 대가 24.6시간 만에 책 404권을 끝냈다: 글자로는 34.6%, 그 뒤 78권은 다시 돌린다
- 7화DGX Spark 두 대가 70시간 동안 책 지도 760권을 만들었다: 토큰 3억 5,800만 개, 함께 돌 때 초당 306토큰
- 8화스파크 한 대당 동시 24개가 스윗스팟이었다: 짧은 일감 분당 32.4건, 32개부터는 처리량은 그대로고 실패만 늘었다
- 9화맥스튜디오는 요청 하나에, 스파크는 일괄 작업에 강했다: 단독 51~66 대 37토큰, 최고 처리량 117 대 163토큰
- 10화맥·스파크·5090에서 돌려본 Qwen3.8 Flash Next