스파크 활용 · 6화
DGX Spark 두 대가 24.6시간 만에 책 404권을 끝냈다: 글자로는 34.6%, 그 뒤 78권은 다시 돌린다
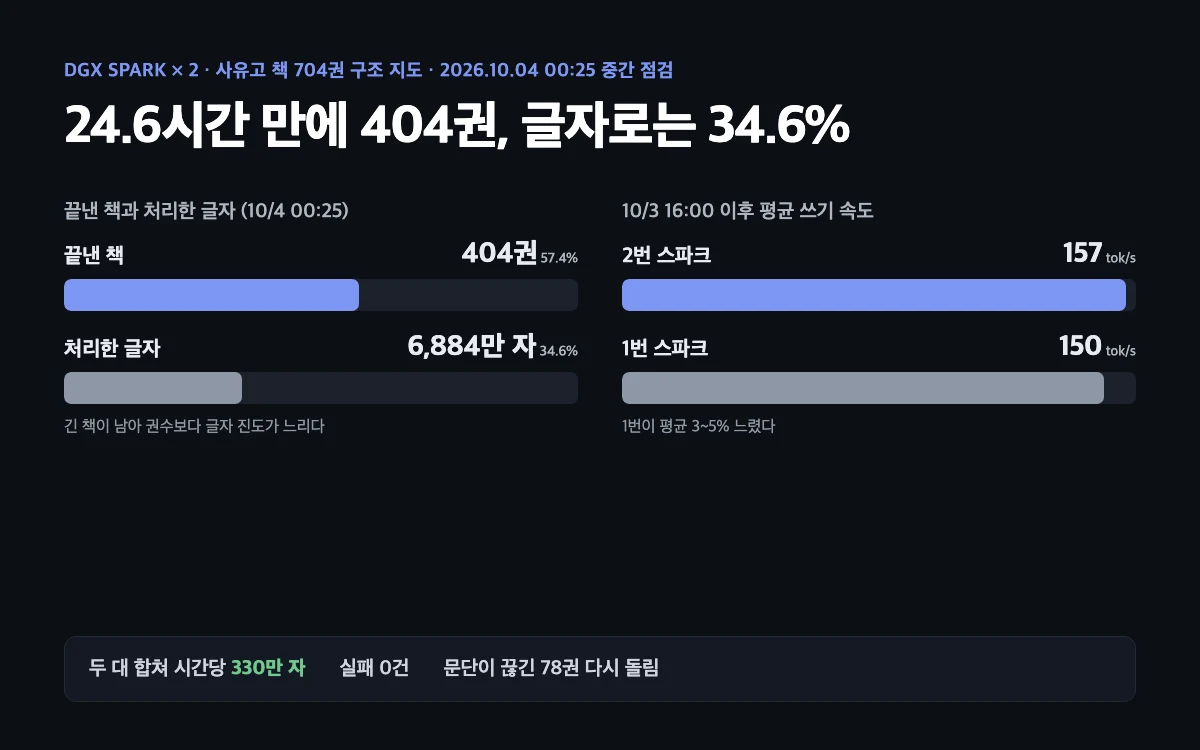
책 704권 구조 지도를 만든 지 24.6시간째인 10월 4일 0시 25분, 404권(57.4%)이 끝났지만 글자로는 34.6%였다. 두 대는 시간당 330만 자를 처리했고 1번이 평균 3~5% 느렸다. 점검 15분 뒤 문단이 줄마다 끊긴 책 78권을 다시 돌리기로 했고, 새벽에는 두 대를 영상에 1시간 48분 내줬다.
4화에서 DGX Spark 두 대가 사유고 책 704권의 구조 지도를 나눠 만들기 시작했다. 10월 2일 밤 11시 50분쯤 시작한 일이다. 이 글은 10월 4일 0시 25분, 시작한 지 24.6시간째의 중간 점검과 그 뒤 네 시간 동안 일어난 일이다.
24.6시간 동안 704권 중 404권을 끝냈지만 글자로는 34.6%였다
| 항목 | 10월 3일 16:00 | 10월 4일 00:25 |
|---|---|---|
| 끝낸 책 | 302권 (42.9%) | 404권 (57.4%) |
| 처리한 글자 | 4,408만 자 (22.2%) | 6,884만 자 (34.6%) |
| 실패 | 0건 | 0건 |
8.5시간 동안 102권, 글자로 12.4%p가 늘었다. 권수로는 절반을 넘겼는데 글자로는 3분의 1을 갓 넘었다. 짧은 책부터 넣었기 때문이다. 이 시각엔 26만~31만 자짜리 책을 처리하고 있었고, 남은 300권은 뒤로 갈수록 더 길다. 진행률은 권수가 아니라 글자로 봐야 한다.
두 대는 시간당 330만 자를 처리했고 1번이 평균 3~5% 느렸다
| 쓰기 속도 | 2번 | 1번 |
|---|---|---|
| 16:00 이후 평균 | 초당 157토큰 | 초당 150토큰 |
| 최근 1시간 평균 | 초당 161토큰 | 초당 157토큰 |
| 16:00 이후 8.5시간 중 일한 시간 | 8.4시간 | 6.8시간 |
| 점검 순간 (최근 1분) | 초당 91토큰 | 초당 205토큰 |
최근 2시간 기준으로 두 대가 합쳐 시간당 약 330만 자를 처리했다. 점검 순간에는 2번이 1번의 절반도 안 나왔는데, 4화에서 본 착시다. 그 순간 2번은 새 원문을 잔뜩 읽어 들이고 있었고 1번은 읽을 게 거의 없었다.
평균으로 보면 이번엔 1번이 3~5% 느렸다. 4화에서는 처음 87분을 보고 두 대가 같다고 썼다. 더 긴 기록을 읽는 양이 같은 구간끼리 비교해도 1번이 2~6% 느렸다. 쓰기만 할 때 초당 210 대 206토큰, 많이 읽을 때 107 대 101토큰이다. 원인은 아직 모른다. 두 대의 리눅스 커널 버전이 다르다는 게 지금의 후보다.
1번이 아침에 네 시간 가까이 빠진 건 딥리서치가 빌려준 서버를 꺼진 것으로 봤기 때문이다
1번은 매일 도는 자동화가 먼저 쓰고, 빌 때만 이 일에 빌려준다. 그런데 10월 3일 아침에는 6시 20분부터 10시 5분까지 1번이 통째로 빠졌다.
- 아침 딥리서치가 6시 21분에 1번의 언어 모델 서버를 꺼진 것으로 잘못 봤다. 서버가 살아 있는지 5초 동안 딱 한 번만 확인했기 때문이다. 실제로는 켜진 채 이 일에 빌려준 상태였다.
- 딥리서치는 1번을 직접 언어 모델 모드로 바꿔 쓰고, 7시에 영상 모드로 되돌렸다.
- 1번을 빌려주는 관리 프로그램은 이 전환을 사람이 손으로 바꾼 것으로 봤다. 사람이 영상 모드로 바꾸면 3시간 동안 빌려 가지 않는 규칙이 있어서, 그동안 1번을 빌려 가지 않았다.
관리 프로그램을 고쳤다. 딥리서치가 돌고 있다는 표시를 본 지 10분 안에 일어난 영상 전환은 딥리서치가 반납한 것으로 본다. 이때는 3시간 쉬지 않고, 영상 서버가 비면 바로 다시 빌린다. 딥리서치 쪽의 잘못된 판정은 다른 프로젝트라 손대지 않았다.
그 뒤로 1번이 빠진 건 계획한 시간뿐이었다. 오후 4시 40분 카드릴스 제작과 저녁 6시 10분부터 6시 49분까지의 딥리서치다. 1번은 6시 53분에 다시 붙었다. 고친 규칙이 실제로 쓰이는 건 10월 4일 아침 6시 20분이다. 밤새 1번을 빌려준 상태로 딥리서치를 맞는 게 그때가 처음이다.
1번 쪽 연결이 세 번 끊겼지만 저장된 호출에서 이어 가 손실은 작았다
16시 이후 1번이 처리하던 책이 연결이 끊겨 대기열로 돌아간 일이 세 번 있었다. 19시 58분, 21시 34분, 23시 56분이다. 두 대를 잇는 터널은 끊기지 않았고 서버 오류도 없었다. 연결 하나가 순간적으로 끊긴 것으로 보이지만 원인은 아직 모른다. 모델 호출은 하나씩 저장해 두기 때문에, 대기열로 돌아간 책은 처음부터가 아니라 저장된 호출 다음부터 이어 간다.
점검 15분 뒤 문단이 줄마다 끊긴 책 78권을 다시 돌리기로 했다
0시 40분, 『돈의 심리학』의 원문 화면을 보다가 문단이 줄마다 끊겨 있는 걸 봤다. 사유고2는 찍어 둔 책의 글자를 문단으로 다시 묶어서 지도를 만든다. 그 규칙은 이랬다. 한 쪽의 줄 길이 중앙값이 60자를 넘으면 한 줄을 한 문단으로 본다. 그런데 판형이 넓은 책은 60자가 넘는 줄도 중간에서 줄을 바꿔 담는다. 단어 한가운데서 끊긴 곳도 있었다. 본문 문단의 절반 이상이 문장 중간에서 끝나는 책이 84권이었다.
규칙을 좁혔다. 한 쪽에서 가장 긴 줄들의 절반 이상이 문장 끝으로 끝날 때만 한 줄을 한 문단으로 본다. 제목이나 쪽 머리글 같은 짧은 줄은 판단에서 뺀다. 704권 전체를 새 규칙으로 다시 나눠 보니 문단 절반 이상이 끊긴 책은 84권에서 1권으로 줄었다. 『돈의 심리학』은 문단 2,925개 가운데 65%가 끊겨 있었는데, 978개로 묶이고 끊긴 문단은 2%가 됐다.
지도가 이미 있는 책 가운데 끊김이 30%를 넘었고 새 규칙으로 10%p 넘게 나아지는 78권을 다시 돌리기로 했다. 1,590만 자, 약 5시간 분량이다. 옛 지도는 지우지 않고 옆으로 옮겨 뒀다. 그래서 404권이던 완료가 0시 39분에 331권으로 내려갔다. 아직 지도가 없던 끊긴 책 52권은 처음부터 새 규칙으로 돈다.
읽던 『돈의 심리학』은 다시 돌릴 대기열의 10번째였다. 그래서 대기열이 15초마다 우선순위 파일을 확인하게 하고, 거기 적힌 책을 맨 앞으로 옮기게 했다. 『돈의 심리학』은 1시 44분에 새 규칙으로 다시 만들어졌다. 1,343초가 걸렸고 논점은 44개다.
새벽 2시에는 두 대를 모두 영상에 내줬다가 1시간 48분 뒤 돌려받았다
새벽 2시쯤 영상을 만들려고 두 대를 모두 쓰겠다고 했다. 영상 모드로 바꾸는 명령은 언어 모델에 요청이 하나라도 남아 있으면 전환을 거부한다. 그래서 순서가 정해져 있다. 1번 대여를 끄고, 배치를 2시 6분에 멈추고, 두 서버의 처리 수가 0이 될 때까지 기다린 뒤 영상 모드로 바꿨다.
돌려받는 일은 작은 프로그램에 맡겼다. 영상 작업이 한 번 돈 뒤 두 대의 영상 대기열이 30분 동안 비면, 영상 작업이 아예 없었으면 90분 뒤에, 또는 내가 “끝”이라고 하면 되돌린다. 3시 51분에 영상 작업이 끝났다고 알렸고, 3시 54분에 2번이 언어 모델로 돌아오며 배치가 다시 켜졌다. 1번은 3시 58분에 다시 빌려졌다. 4시 13분 현재 704권 중 361권이 끝났고 335권이 남았다. 실패는 여전히 0건이다.
완료 예상은 10월 5일 오후 5~6시에서 자정 전후로 밀렸다
0시 25분에 남은 글자는 1억 3,019만 자였다. 그 속도로 약 39시간, 1번이 자동화로 빠지는 시간까지 2시간을 더해 10월 5일 오후 5~6시 무렵에 끝날 것으로 봤다. 그 뒤 다시 돌릴 78권(약 5시간)과 영상 휴식 1시간 48분이 더해졌다. 단순히 더하면 10월 5일 자정 전후다. 1번이 10월 4일 아침·저녁과 10월 5일 아침 자동화로 빠지는 시간은 이미 넣은 값이다.
배운 것
진행률은 무엇으로 세느냐에 따라 다른 말을 했다. 같은 순간 권수로는 57.4%, 글자로는 34.6%였다. 짧은 책부터 넣는 대기열에서 권수는 앞쪽에서 빨리 차고 뒤쪽에서 느려진다.
품질 문제를 찾으면 진행률은 거꾸로 간다. 404권이 331권이 됐다. 옛 지도를 지우지 않고 옮겨 둔 덕에, 새 규칙이 어느 책의 어느 문단을 바꿨는지 나란히 비교할 수 있다.
장비를 나눠 쓰는 프로그램끼리는 서로의 행동을 오해할 수 있었다. 딥리서치는 빌려준 서버를 꺼진 것으로 봤고, 대여 관리자는 딥리서치의 전환을 사람의 손으로 봤다. 둘 다 각자의 규칙대로 맞게 움직였는데 1번은 네 시간 가까이 놀았다.
스파크 활용 · 전 10화
- 1화DGX Spark의 Qwen3.8이 하루 딥리서치 31건을 썼다: 10월 1일 시황 뉴스를 한 건씩 조사한 보고서
- 2화DGX Spark는 한 건씩보다 다섯 건을 동시에 돌릴 때 빨랐다: 딥리서치 17건을 48분에 끝냈다
- 3화DGX Spark 2번을 한 시간 반 만에 1번과 똑같이 세웠다: 같은 시드 영상 313초 대 319초
- 4화DGX Spark 두 대가 책 704권을 나눠 정리한다: 속도가 달라 보인 건 원문을 읽던 순간이었다
- 5화DGX Spark를 두 대로 늘리자마자 엔비디아가 두 대를 묶으면 대역폭이 두 배라고 발표했다
- 6화DGX Spark 두 대가 24.6시간 만에 책 404권을 끝냈다: 글자로는 34.6%, 그 뒤 78권은 다시 돌린다
- 7화DGX Spark 두 대가 70시간 동안 책 지도 760권을 만들었다: 토큰 3억 5,800만 개, 함께 돌 때 초당 306토큰
- 8화스파크 한 대당 동시 24개가 스윗스팟이었다: 짧은 일감 분당 32.4건, 32개부터는 처리량은 그대로고 실패만 늘었다
- 9화맥스튜디오는 요청 하나에, 스파크는 일괄 작업에 강했다: 단독 51~66 대 37토큰, 최고 처리량 117 대 163토큰
- 10화맥·스파크·5090에서 돌려본 Qwen3.8 Flash Next