스파크 활용 · 4화
DGX Spark 두 대가 책 704권을 나눠 정리한다: 속도가 달라 보인 건 원문을 읽던 순간이었다
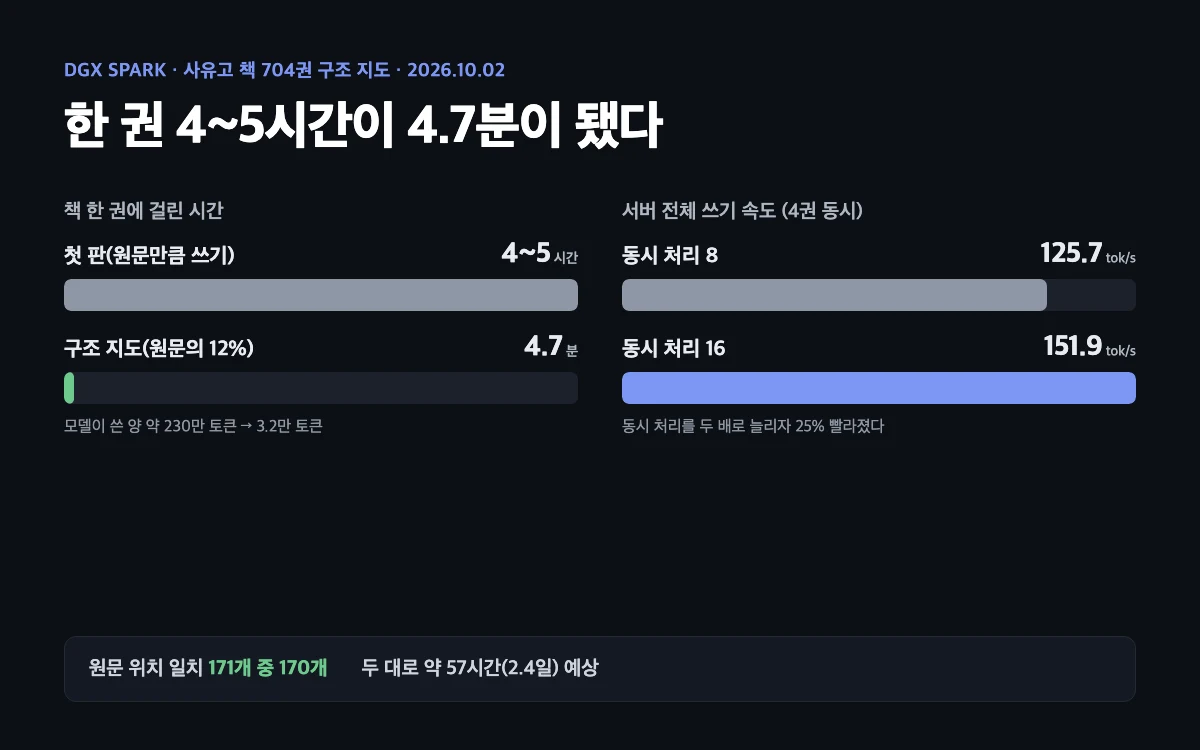
2번 Spark의 첫 일은 사유고 책 704권의 구조 지도다. 첫 판은 한 권에 4~5시간이었고, 원문의 12% 지도로 줄이자 4.7분이 됐다. 서버 동시 처리를 16으로 올리고 두 대로 나누니 약 2.4일 예상이다. 두 대의 속도가 크게 달라 보인 숫자는 기계가 아니라 측정한 순간의 차이였다.
3화에서 1번과 똑같이 세운 2번에게 첫 일을 맡겼다. 사유고는 찍어 둔 종이책을 물어볼 수 있게 만든 서재다. 거기 담긴 책마다 구조 지도를 만든다. 이 책이 묻는 것과 그 답, 큰 축 몇 개, 축마다 논점, 논점마다 핵심 주장과 그 받침(근거·사례·조건·반론)을 정리하고, 모든 항목을 원문 문장에 묶는다. 모델은 1번과 같은 Qwen3.8 Flash Next다. 맥의 사유고에서는 원문만 한 방향으로 2번에 보낸다.
첫 판은 한 권에 4~5시간 걸렸고 원문의 57배를 쓸 판이었다
처음엔 미리 써 둔 꼼꼼한 지침을 그대로 돌렸다. 짧은 편인 『불안사회』 한 권으로 시험했는데, 끝나려면 4시간 반에서 5시간이 걸릴 판이었다. 호출 기록을 세어 보니 원인은 모델이 쓰는 양이었다.
| 항목 | 값 |
|---|---|
| 책 원문 | 약 4만 토큰 |
| 모델이 쓸 양(끝까지 갔을 때 예상) | 약 230만 토큰, 원문의 57배 |
| 그중 답하기 전에 혼자 생각한 분량 | 44% |
| 고쳐 쓰게 한 호출 | 161번 중 61번(38%), 주로 인용문이 원문과 글자가 달라서 |
원문을 편하게 보려고 만드는 정리가 원문보다 클 수는 없었다. 그래서 지도를 다시 정의했다. 원문보다 훨씬 작게, 원문의 10% 안팎으로. 모델이 답하기 전에 생각하는 단계는 껐다. 같은 질문의 답이 7.5초에서 1.1초로 줄었다. 인용은 원문 글자 그대로 쓰게 하고, 남의 말을 저자의 말로 적는 실수는 코드가 원문과 대조해 잡게 했다.
원문의 12% 지도로 바꾸자 한 권이 4.7분이 됐다
같은 책을 다시 돌렸다.
| 첫 판 | 구조 지도 | |
|---|---|---|
| 한 권 시간 | 4~5시간(중간에 멈춤) | 4.7분 |
| 모델이 쓴 양 | 약 230만 토큰(예상) | 3.2만 토큰 |
| 정리본 분량 | 원문만큼 | 원문의 11.8% |
| 원문 위치가 글자 그대로 맞은 항목 | – | 171개 중 170개 |
서버 동시 처리를 8에서 16으로 늘리자 25% 빨라졌다
2화에서 딥리서치를 다섯 건씩 동시에 돌리면 전체가 빨라지는 걸 봤다. 이번에는 서버가 한 번에 받아 주는 요청 수(vLLM의 동시 처리 수)를 바꿔 봤다. 책 네 권을 동시에 넣었다.
| 설정 | 걸린 시간 | 서버 전체 쓰기 속도 | 요청 하나의 쓰기 속도 |
|---|---|---|---|
| 1권 단독 | 4.7분 | 초당 113.6토큰 | – |
| 4권, 동시 처리 8 | 17.0분 | 초당 125.7토큰 | 초당 16.8토큰 |
| 4권, 동시 처리 16 | 13.6분 | 초당 151.9토큰 | 초당 11.8토큰 |
동시 처리 16이 25% 빨랐다. 두 배가 아닌 건 요청이 늘어난 만큼 요청 하나가 느려지기 때문이다. 2화의 엘리베이터와 같은 이야기다.
여러 권을 동시에 넣는 효과는 생각보다 작았다. 프로그램이 책 한 권도 6~10개 구간으로 나눠 한꺼번에 묻기 때문에, 한 권만 넣어도 서버가 거의 찬다. 속도를 정하는 건 권수가 아니라 서버의 동시 처리 수였다. 그렇다고 에이전트 16개가 도는 건 아니다. 모델은 하나이고 요청 16개를 한 묶음으로 같이 계산한다. 구간 나누기, 원문 대조, 고쳐 쓰기 요청, 합치기는 코드가 정하고 모델은 질문 하나에 답 하나만 낸다.
평균을 깎는 건 꼬리였다. 16자리가 꽉 찬 동안은 초당 약 182토큰을 썼는데, 끝난 책이 생기며 요청이 줄어든 마지막 20% 구간은 약 105토큰이었다. 그래서 전체를 돌릴 때는 네 권씩 묶어 기다리지 않고, 한 권이 끝나면 바로 다음 권을 넣는 대기열로 바꿨다.
짧은 책으로 잰 1.6일은 틀렸고 분량으로 다시 재니 두 대로 2.4일이었다
처음엔 한 대로 686권에 1.6일이라고 계산했다. 시험한 책 한 권의 시간에 권수를 곱한 값이었다. 그런데 시험한 다섯 권은 평균 8.5만 자로, 서재의 평균 28.3만 자보다 3.3배 짧았다. 글자 수로 다시 쟀다.
| 항목 | 값 |
|---|---|
| 686권 원문 | 1억 9,410만 자 |
| 원문 1자당 모델이 쓴 토큰 (시험 5권 실측) | 0.379 |
| 전체 쓸 양 | 약 7,350만 토큰 |
| 한 대 (초당 180토큰 유지) | 약 113시간 (4.7일) |
| 두 대 | 약 57시간 (2.4일) |
1번은 자동화가 먼저 쓰고 빌 때만 빌려준다
2번은 처음부터 끝까지 이 일만 한다. 1번에는 매일 도는 자동화가 있다. 오후 5시 25분 카드릴스 영상 제작과 아침·저녁 딥리서치다. 그래서 1번은 빌 때만 빌려 쓰기로 했다. 맥의 작은 관리 프로그램이 1분마다 판단한다.
- 카드릴스: 매일 오후 4시 40분에 진행 중인 요청만 마무리하고 1번을 영상 모드로 돌려준다. 제작이 끝나고 비면 다시 참여한다.
- 딥리서치: 도는 동안은 1번에 새 요청을 넣지 않고, 시작 직전에는 모드도 바꾸지 않는다.
- 사람이 1번을 영상 모드로 바꾸면 3시간 동안 빌려 가지 않는다.
- 1번을 돌려주느라 끊긴 책은 대기열로 돌아가 저장된 호출부터 이어 간다.
전체 실행은 10월 2일 밤 11시 54분에 시작했다. 짧은 책부터 넣어서 30분에 24권, 1시간에 44권이 끝났다. 권수로는 빨라 보이지만 분량으로는 1.3%다. 실패는 0건이었고 두 대가 합쳐 초당 약 360토큰을 썼다. 그사이 사유고에 18권이 더 들어와 대기열은 704권이 됐다. 대기열이 10분마다 목록을 다시 읽도록 고쳐서, 이제는 새 책을 보내기만 하면 이어서 들어간다. 1번이 자동화로 빠지는 시간까지 넣으면 10월 5일 저녁에서 6일 아침 사이에 끝날 것으로 본다. 끝난 지도는 10분마다 맥으로 복사돼 따로 만든 보기 앱에 쌓인다.
두 대의 속도 차이는 원문을 읽던 순간의 착시였다
실행 한 시간쯤 지나 30초 동안 속도를 쟀더니 1번이 초당 212토큰, 2번이 148토큰이었다. 같은 칩에 같은 세팅인데 40% 넘게 차이가 났다. 2분 동안 다시 재니 거꾸로 2번이 202, 1번이 138이었다.
토큰/초는 서버가 쓴 토큰만 센다. 그런데 요청이 새로 시작될 때마다 서버는 그 구간의 원문 약 8천 토큰을 먼저 읽어야 한다. 읽기와 쓰기는 같은 GPU를 나눠 쓴다. 처음 잰 30초 동안 2번에는 새 요청이 몰려 초당 830~870토큰씩 원문을 읽고 있었고, 그동안 쓰기는 초당 71~209토큰으로 떨어졌다. 1번은 읽을 게 없어서 쓰기만 했다.
두 서버가 10초마다 남긴 기록에서 읽던 양이 같은 순간끼리 묶으면 쓰기 속도는 같았다.
| 그 순간 읽던 양 | 2번 쓰기 | 1번 쓰기 |
|---|---|---|
| 읽기 없음 | 초당 210토큰 | 초당 215토큰 |
| 초당 600~1,000토큰 | 152 | 146 |
| 초당 1,000토큰 이상 | 101 | 110 |
87분 전체 평균도 초당 156토큰과 163토큰으로 비슷했다. 10초 단위로 보면 앞서는 쪽이 174번 바뀌었다. 30초만 재면 그때그때 어느 쪽이든 빨라 보일 수 있다는 뜻이다. 장비 상태도 같았다. 둘 다 클럭 2.4GHz, 전력 41~44W에 과열로 속도를 줄인 흔적이 없었다. 다음 토큰 몇 개를 미리 짐작해 쓰는 추측 디코딩의 적중률도 둘 다 92%였다. 2번이 7도 더 뜨거웠지만(74°C 대 67°C) 속도에는 영향이 없었다.
같은 시간에 끝낸 권수가 달랐던 것도 기계 탓이 아니었다. 50분 동안 끝난 33권으로 보면 책 한 권이 1초에 쓴 양은 2번 38.4토큰, 1번 39.7토큰으로 같았다. 다만 1번이 맡은 책들은 원문 1,000자당 417토큰을 써야 했고, 2번이 맡은 책들은 300토큰이면 됐다. 비는 쪽이 다음 책을 가져가니 어느 책이 어디로 갈지는 우연이고, 끝까지 돌면 고르게 섞인다.
관제탑에 서버 전체 쓰기 속도와 읽기 속도를 띄웠다
이 일로 관제탑 화면도 고쳤다. 원래 관제탑의 속도 숫자는 요청 하나 기준이라, 16건이 동시에 돌면 초당 12토큰쯤으로 나와 서버 전체 속도와 헷갈렸다. 그 숫자의 이름을 ’요청당’으로 바꾸고, 모델 줄에 서버 전체가 최근 1분 동안 쓴 속도를 넣었다. 마우스를 올리면 읽는 속도도 나온다. 쓰기 숫자가 떨어지면 원문을 읽는 중인지 바로 볼 수 있다.
2번이 관제탑에서 쉬는 것으로 보이던 문제도 같이 찾았다. 관제탑 에이전트는 docker에 물어서 모델이 떠 있는지 본다. 2번을 세팅하면서 계정에 docker 권한을 줬는데, 그때 이미 떠 있던 백그라운드 서비스 관리자가 띄운 에이전트는 재부팅 전까지 새 권한을 받지 못했다. 에이전트가 docker 권한을 갖고 뜨도록 설정 파일을 하나 더하고 에이전트만 다시 켜자, 2번도 ’처리 중 16’으로 나왔다.
배운 것
같은 장비의 속도를 비교할 때는 같은 순간, 같은 조건끼리 비교해야 했다. 토큰/초는 쓴 양만 세고, 그 숫자는 그 순간 읽던 양에 따라 크게 흔들렸다. 30초 순간값 두 개로 기계 차이를 말하면 틀린다.
짧은 표본으로 잰 한 권 시간에 권수를 곱해도 틀린다. 책은 길이가 제각각이라 분량으로 계산해야 했다.
모델이 쓰는 양이 곧 시간이었다. 한 권 4~5시간이 4.7분이 된 건 장비를 바꿔서가 아니라 쓰게 하는 양을 230만 토큰에서 3.2만 토큰으로, 약 70분의 1로 줄여서다.
그리고 서로 독립인 일은 두 대를 묶지 않아도 나눠 돌리면 그대로 두 배가 된다. 책 704권은 각자 따로 처리하면 되는 일이라 두 대가 비는 대로 가져가게 했다. 큰 모델 하나를 두 대에 나눠 올리는 일은 그런 모델이 필요해질 때 고정 IP부터 넣고 하면 된다.
스파크 활용 · 전 10화
- 1화DGX Spark의 Qwen3.8이 하루 딥리서치 31건을 썼다: 10월 1일 시황 뉴스를 한 건씩 조사한 보고서
- 2화DGX Spark는 한 건씩보다 다섯 건을 동시에 돌릴 때 빨랐다: 딥리서치 17건을 48분에 끝냈다
- 3화DGX Spark 2번을 한 시간 반 만에 1번과 똑같이 세웠다: 같은 시드 영상 313초 대 319초
- 4화DGX Spark 두 대가 책 704권을 나눠 정리한다: 속도가 달라 보인 건 원문을 읽던 순간이었다
- 5화DGX Spark를 두 대로 늘리자마자 엔비디아가 두 대를 묶으면 대역폭이 두 배라고 발표했다
- 6화DGX Spark 두 대가 24.6시간 만에 책 404권을 끝냈다: 글자로는 34.6%, 그 뒤 78권은 다시 돌린다
- 7화DGX Spark 두 대가 70시간 동안 책 지도 760권을 만들었다: 토큰 3억 5,800만 개, 함께 돌 때 초당 306토큰
- 8화스파크 한 대당 동시 24개가 스윗스팟이었다: 짧은 일감 분당 32.4건, 32개부터는 처리량은 그대로고 실패만 늘었다
- 9화맥스튜디오는 요청 하나에, 스파크는 일괄 작업에 강했다: 단독 51~66 대 37토큰, 최고 처리량 117 대 163토큰
- 10화맥·스파크·5090에서 돌려본 Qwen3.8 Flash Next